
Montagmorgen in einem Mittelständler, die Buchhaltung kommt nicht ins ERP, der Einkauf wartet auf Freigaben, und die Geschäftsführung will wissen, warum der Tagesbetrieb stockt. In der Praxis ist das oft kein exotischer Angriff, sondern ein seit Wochen offenes Sicherheitsloch, das niemand zentral verfolgt hat. Genau an dieser Stelle trennt sich improvisiertes Updaten von einem Patch Management Server, der Updates nicht nur verteilt, sondern den gesamten Prozess belastbar steuert und belegt.
Wer als Geschäftsführer oder IT-Verantwortlicher heute noch auf manuelle Einzelupdates setzt, erkauft sich vermeintliche Einfachheit mit einem Chaos aus unklaren Zuständigkeiten, fehlenden Nachweisen und unnötigem Risiko. Das BSI beschreibt Patchmanagement als Prozess zum raschen Erhalten, Verwalten und Einspielen verfügbarer Patches, und es verankert das im Grundschutz als kontrollierbaren Betriebsprozess im BSI-Grundschutz-Baustein OPS.1.1.3. Für KMU ist das keine Theorie. Es ist die Basis dafür, dass Updates schnell ankommen, dokumentiert bleiben und im Zweifel auch gegenüber Prüfungen sauber nachweisbar sind.
Inhaltsverzeichnis
- Warum ein zentraler Patch Management Server für KMU unverzichtbar ist
- Inventarisierung als Fundament des Patch Prozesses
- Test- und Freigabeprozess vor dem Rollout
- On-Prem, hybrid oder cloud-basiert die richtige Architektur wählen
- Automatisierung Zeitpläne und Reporting im Alltag
- Rollback-Strategien und Ausnahmen sauber dokumentieren
- Monitoring NIS2 Nachweis und der 90 Tage Startplan
Warum ein zentraler Patch Management Server für KMU unverzichtbar ist
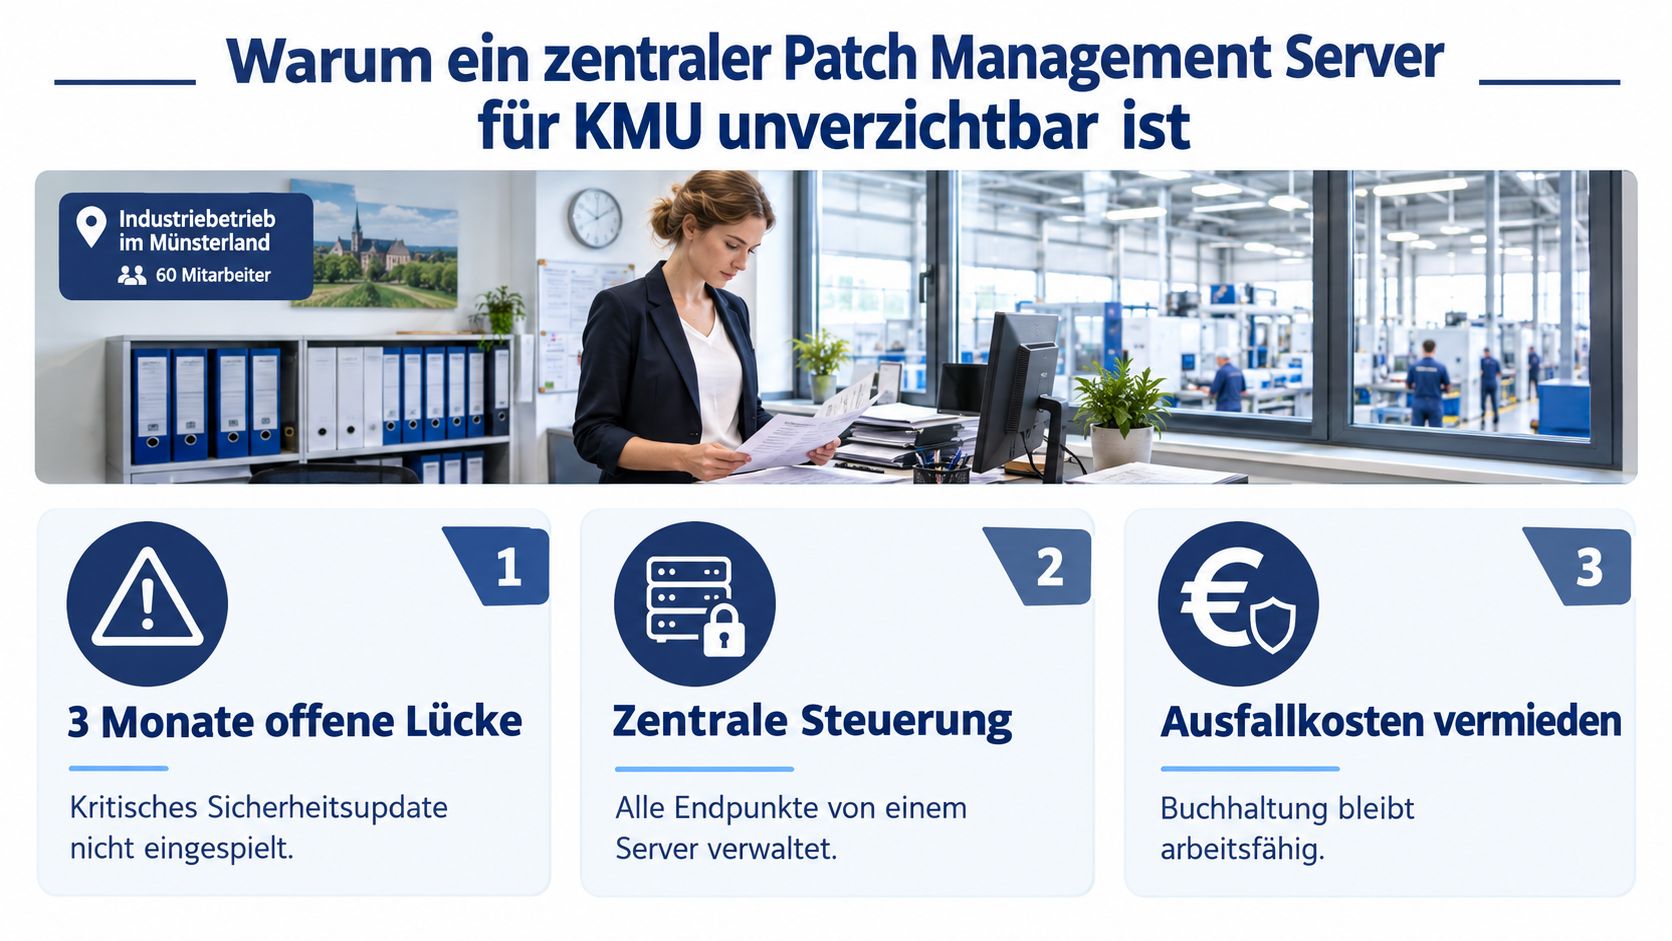
Wenn morgens die Buchhaltung steht, ist die eigentliche Frage nicht, welcher Anwender geklickt hat. Die Frage ist, warum ein bekanntes Sicherheitsloch noch offen war und niemand es zentral ausgerollt, geprüft und dokumentiert hat. In einem 60-Mitarbeiter-Betrieb reicht dafür oft schon eine einzige veraltete Maschine, ein nicht gepflegtes Notebook im Außendienst oder ein Server, dessen Update nur lokal angestoßen wurde.
Was ohne zentrale Steuerung schiefgeht
Das BSI hat im Lagebericht 2024 für das Jahr 2023 durchschnittlich 78 neu bekannt gewordene Schwachstellen pro Tag und monatlich 18 Zero-Day-Meldungen dokumentiert, zusätzlich im Schnitt sechs Meldungen pro Monat zu falsch konfigurierten Servern oder fehlenden Patches bereits bekannter Schwachstellen BSI-Lagebericht 2024. Diese Lage macht klar, warum Einzelaktionen nicht mehr reichen. Ohne zentrale Instanz fehlen oft die Übersicht über alle Endpunkte, die Zuordnung zu einem Verantwortlichen und die Frage, ob ein Update wirklich überall angekommen ist.
Ein Patch Management Server reduziert genau diese Lücken. Er schafft einen Ort, an dem Update-Status, CVE-Bezug, Freigabe und Auslieferung zusammenlaufen. Das ist für KMU wichtig, weil sich damit nicht nur das Risiko senken lässt, sondern auch die Nachweisbarkeit verbessert, etwa für NIS2-nahe Prüfungen und interne Kontrollen.
Praxisregel: Wer Updates nicht zentral sieht, kann sie auch nicht revisionssicher belegen.
Der Nutzen im Alltag
In regulierten Branchen ist der zentrale Server mehr als ein Verteilwerkzeug. Er ist ein Steuerungsinstrument für Wartungsfenster, Prioritäten und Eskalation. Gerade in Umgebungen mit vielen Servern und gemischten Windows- und Linux-Systemen verhindert er Wildwuchs, weil nicht jede Abteilung ihre eigene Update-Logik baut.
Das Ergebnis ist nüchtern und wertvoll zugleich, weniger ungeplante Vorfälle, kalkulierbare Wartungsfenster und ein Berichtswesen, das im Audit nicht erst am Vortag zusammengesucht werden muss. Wer diesen Prozess sauber aufsetzt, gewinnt Zeit für den Betrieb statt für Schadensbegrenzung.
Inventarisierung als Fundament des Patch Prozesses
Ohne vollständige Inventarisierung ist jeder Patch-Prozess ein Blindflug. Das merkt man in KMU besonders schnell, wenn ein alter Applikationsserver im Lagerraum, ein nicht dokumentiertes Testsystem oder ein virtueller Restbestand aus einem früheren Projekt noch produktiv erreichbar ist. Ein Patch Management Server kann nur das steuern, was er kennt.
Die Asset-Liste zuerst
Die erste Aufgabe ist nicht das Patchen, sondern das Erfassen. Dazu gehören physische Server, virtuelle Maschinen, Netzwerkgeräte und exponierte Anwendungen, idealerweise automatisiert über zentrale Werkzeuge wie WSUS, SCCM, Wazuh oder ein freies Tool wie NetBox. Der Punkt ist einfach, wenn ein Gerät nicht in der Liste steht, erscheint es später auch nicht im Patch-Report.
Die Checkliste für die Erfassung sollte knapp, aber hart sein:
- Systemtyp erfassen: Physisch, virtuell, Cloud-Instanz oder Appliance.
- Betriebssystem und Version notieren: Ohne diese Basis bleibt die Patch-Zuordnung unvollständig.
- Anwendungen und Rollen aufnehmen: Datenbank, Fileservice, Domänenrolle, ERP-Komponente.
- Eigentümer zuweisen: Wer entscheidet über Freigabe und Wartungsfenster?
- Unbekannte Geräte separat listen: Nichts wird stillschweigend übernommen.
Kritikalität und Abhängigkeiten
Im zweiten Schritt werden Systeme in Kritikalitätsklassen eingeteilt. Tier 1 ist produktiv und kritisch, Tier 2 ist intern wichtig, Tier 3 umfasst Test und Entwicklung. Das ist nicht nur eine technische Ordnung, sondern die Grundlage dafür, wie schnell gepatcht wird und wer die Freigabe erteilt.
Der dritte Schritt ist die Abhängigkeitsdokumentation. Wer weiß, dass ein Server Authentifizierung, SQL-Zugriffe oder Lizenzdienste für mehrere Anwendungen bereitstellt, plant Updates anders. Ohne diese Zuordnung führt ein einfacher Reboot schnell zu einem Kaskadeneffekt.
| Tier | Beispielsysteme | Patch-Frequenz | Freigabeprozess |
|---|---|---|---|
| Tier 1 | ERP, Domänencontroller, produktive Datenbanken | Sehr zeitnah, priorisiert nach Risiko | Verantwortliche Leitung, Testnachweis, dokumentierte Freigabe |
| Tier 2 | Interne Fachanwendungen, Fileserver, Druckserver | Geplant im Wartungsfenster | IT-Administrator mit Standardfreigabe |
| Tier 3 | Test, Entwicklung, Staging | Regulär, vor produktiven Wellen | Technische Freigabe ohne Produktionsbezug |
Eine praxisnahe Ergänzung zur Risikoermittlung findet sich im Leitfaden zum Vulnerability Assessment für KMU und Kliniken. Dort geht es sinnvollerweise darum, Schwachstellen nicht isoliert, sondern im Kontext des tatsächlichen Betriebs zu bewerten.
Test- und Freigabeprozess vor dem Rollout
Patches scheitern in KMU selten am Download. Sie scheitern an einem Update, das auf dem Testsystem gut aussah, aber im Produktivbetrieb eine Schnittstelle, einen Druckdienst oder eine alte Treiberversion zerschossen hat. Deshalb gehört ein geordneter Test- und Freigabeprozess zwingend in jeden Patch Management Server.
Wartungsfenster und Pilot-Ring
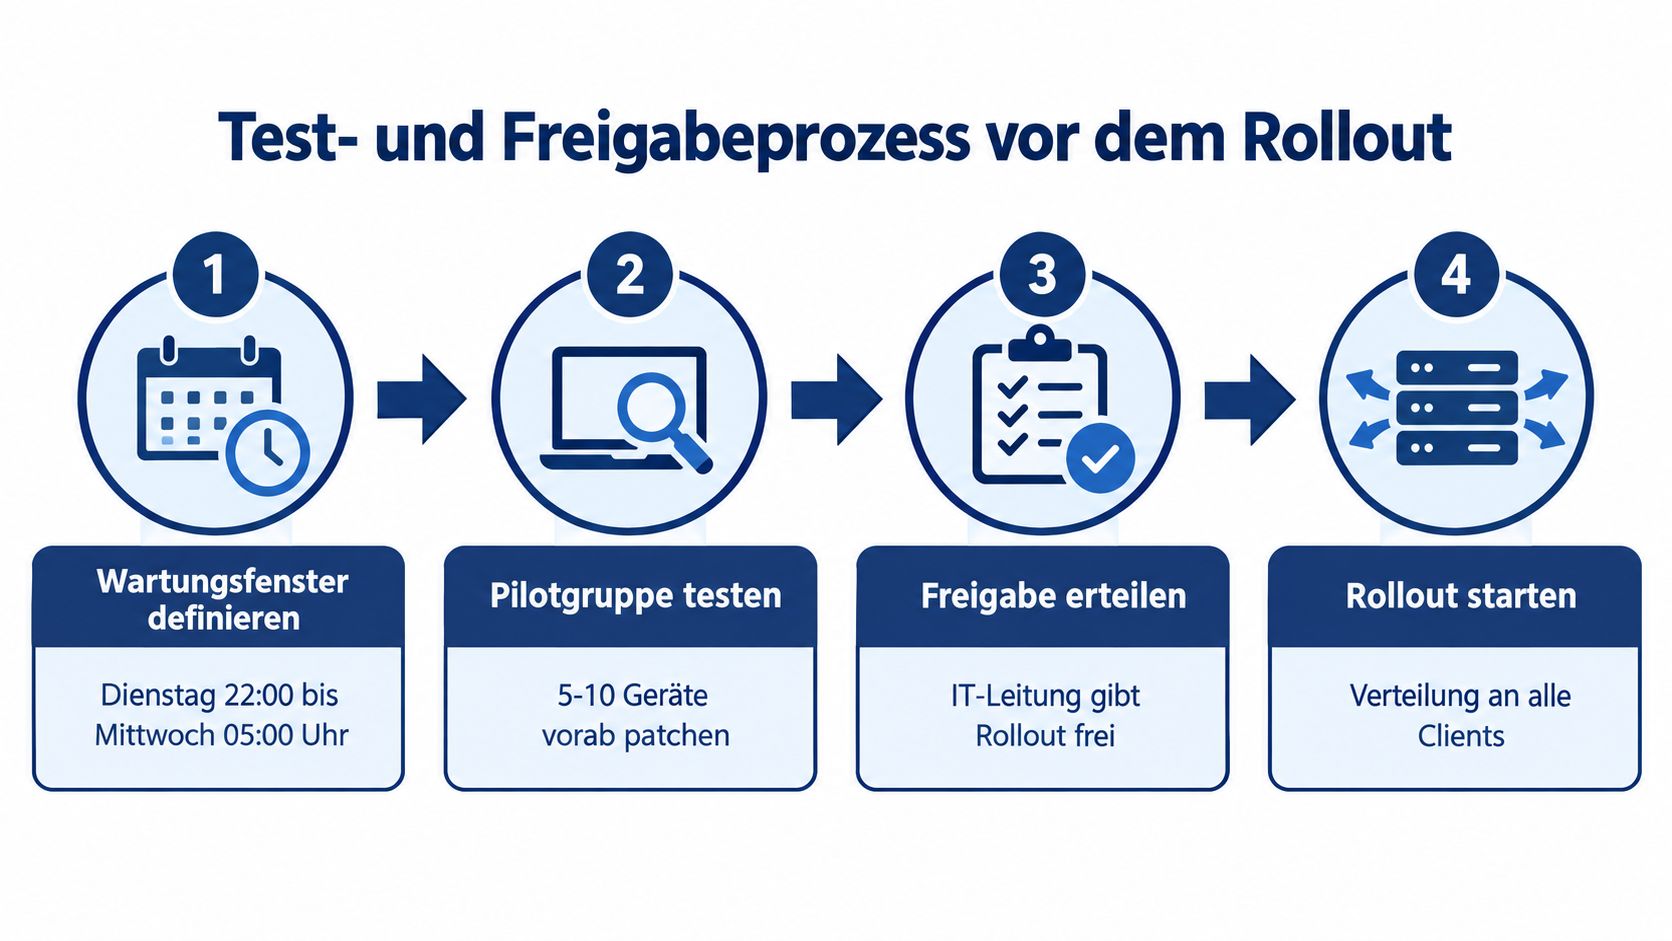
Für Produktivsysteme braucht es feste Wartungsfenster, zum Beispiel dienstags abends bis in die Nacht hinein oder in ein eng definiertes Nachtfenster. Wichtig ist nicht die Uhrzeit an sich, sondern die Disziplin dahinter. Wer jedes Mal neu diskutiert, ob „heute ausnahmsweise“ gepatcht wird, verliert den Prozess.
Der Pilot-Ring sollte klein bleiben, meist reichen 5 bis 10 Prozent der Server. Entscheidend ist, dass diese Systeme die produktive Realität möglichst gut abbilden, also ähnliche Betriebssystemstände, identische Applikationsversionen und, wenn nötig, denselben Datenbankschema-Stand. Ein Labor mit künstlich glatten Bedingungen sagt wenig über den echten Betrieb.
Freigabekriterien, die man auch wirklich prüfen kann
Ein Update geht erst in den breiten Rollout, wenn die Grundlagen stimmen. Dazu gehören keine schweren Fehler nach einer Beobachtungsphase, keine auffälligen Ressourcenspitzen, grüne Funktionstests und eine dokumentierte Freigabe durch den zuständigen Administrator. Wer diese Punkte nicht schriftlich festhält, hat im Streitfall keinen belastbaren Nachweis.
Ein sauberer Rollout ist kein Glückstreffer. Er ist das Ergebnis einer Freigabe, die vor dem Produktivstart bereits entschieden wurde.
Die praktische Checkliste für jedes Wartungsfenster lautet:
- Patch-Kandidaten benennen: Welche Systeme stehen heute an?
- Abhängigkeiten prüfen: Gibt es offene Benutzerprozesse oder Schnittstellenfenster?
- Pilotgruppe aktualisieren: Erst dort messen, dann breiter ausrollen.
- Beobachten und protokollieren: Fehler, Neustarts, Dienste, Latenzen.
- Sign-off dokumentieren: Wer hat die Freigabe erteilt und warum?
On-Prem, hybrid oder cloud-basiert die richtige Architektur wählen
Die Architektur eines Patch Management Servers entscheidet nicht nur über Technik, sondern über Betriebsrealität. Ein Betrieb mit eigener Serverlandschaft, enger Datenschutzvorgabe und lokalem Admin-Team braucht etwas anderes als ein Verband mit mehreren Niederlassungen oder eine Kanzlei mit vielen mobilen Geräten.
Die drei Modelle im direkten Vergleich
On-Prem ist naheliegend, wenn Updates intern bleiben sollen. Das passt zu klassischen KMU, produktionsnahen Umgebungen und Situationen mit eingeschränktem Internetzugang. Hybrid ist sinnvoll, wenn Standorte verteilt sind und lokale Zwischenschritte den Datenverkehr und den Administrationsaufwand senken sollen. Cloud-zentrierte Ansätze spielen ihre Stärke dort aus, wo kaum eigene Rechenzentrumslogik vorhanden ist und die Steuerung zentral über ein Web-Portal laufen darf.
| Kriterium | On-Prem | Hybrid | Cloud |
|---|---|---|---|
| Standort der Konsole | Im eigenen Netz | Zentrale Konsole plus lokale Relais | Im Anbieterportal |
| Bandbreite | Geringe externe Abhängigkeit | Entlastet Standorte durch Zwischenspeicher | Abhängig von stabiler Internetverbindung |
| Internetabhängigkeit | Niedriger | Mittel | Hoch |
| Administrationsaufwand | Intern höher, dafür kontrolliert | Ausgewogen | Operativ oft am bequemsten |
| NIS2-Nachweisfähigkeit | Sehr gut, wenn sauber protokolliert | Gut, wenn zentrale Berichte sauber angebunden sind | Gut, aber Telemetrie liegt beim Anbieter |
Für ein Handwerksunternehmen mit lokalem Serverraum ist On-Prem meist die nüchterne Wahl. Für einen Klinikverbund mit mehreren Standorten ist hybrid oft praktikabler, weil Rollout und Reporting zentral laufen, ohne jeden Standort gleich zu belasten. Reine Cloud-Ansätze passen eher zu schlanken IT-Teams ohne eigenes Rechenzentrum.
Wer das Thema tiefer auf Microsoft-lastige Umgebungen herunterbrechen will, findet im Beitrag zu Microsoft Intune einen hilfreichen Einstieg in die zentrale Geräteverwaltung. In der Praxis kann so ein Ansatz Teil einer hybriden Patch-Strategie sein, wenn Server, Notebooks und Außendienstgeräte gemeinsam betrachtet werden.
Automatisierung Zeitpläne und Reporting im Alltag
Im Alltag setzt sich nicht der durch, der am lautesten patcht, sondern der, dessen Ablauf sauber läuft. Ein Patch Management Server muss daher mehr können als Updates verteilen. Er braucht feste Zeitfenster, klare Freigaben und Berichte, die im Audit Bestand haben, auch wenn später eine CVE nachverfolgt werden muss.
Zeitpläne nach Kritikalität
Sicherheitsupdates und Mitigations gehören zuerst in den Prozess. Der BSI-Leitfaden Patchmanagement empfiehlt, Schwachstellen und Updates zügig zu behandeln und nicht bis zum nächsten Regeltermin liegen zu lassen. Funktionale Updates können in einen planbaren Monatsrhythmus. Feature-Updates gehören in ein engeres Wartungsfenster mit vorheriger Freigabe.
So bleibt der Betrieb steuerbar:
- Sicherheitsrelevant: nach Prüfung und Freigabe so früh wie möglich.
- Funktional: gebündelt im regelmäßigen Wartungsfenster.
- Feature- oder Versionssprünge: nur nach Test und dokumentierter Entscheidung.
- Sonderfälle: nur mit befristeter Ausnahme und klarer Kontrolle.
Ringe, Berichte und Eskalation
Im Tagesbetrieb arbeiten gute Systeme mit Ringen. Pilot, Early Adopter und Produktion sind keine Etiketten für Folien, sondern ein Schutz gegen flächige Fehler. Erst wenn der erste Ring stabil läuft, geht es weiter. Bricht der erste Ring ab, ist das ärgerlich, aber immer noch besser als ein Produktionsstopp im ganzen Unternehmen.
Für Microsoft-lastige Umgebungen sind WSUS mit SCCM, für Linux-Server Ansible AWX, für Drittanbieter-Software PDQ Deploy und als übergreifende Konsole ManageEngine Patch Manager Plus realistische Optionen. GSL Groß GmbH bietet in diesem Umfeld Server- und Storage-Dienstleistungen für Microsoft-Server sowie virtuelle und physische Client- und Serversysteme an, was bei der technischen Einbindung eines solchen Betriebsmodells helfen kann.
Wer Freigaben und Abstimmung im Alltag sauberer ziehen will, kann Prozesse mit Geschäftsprozesse automatisieren leicht gemacht organisatorisch an den Patch-Prozess anbinden. Das ersetzt kein Patch-Tool, reduziert aber Rückfragen, Medienbrüche und ungeklärte Zuständigkeiten.
Ein kompaktes Wochenreporting an die Geschäftsführung kann so aussehen:
Betreff: Patch-Status KW 38
Kurzlage: Alle freigegebenen Sicherheitsupdates wurden in den produktiven Ring übernommen.
Offene Punkte: Zwei Systeme warten auf Ausnahmeentscheidung, ein Testlauf wurde wegen Applikationsfehler abgebrochen.
Risiko: Der aktuelle Status ist kontrolliert, nächste Prüfung im geplanten Wartungsfenster.
Für die Quartalsauswertung braucht das Unternehmen keine Zahlenakrobatik, sondern belastbare Berichte über Patch-Status, übersehene Patches und unterbrochene Rollouts. So entsteht Nachweis pro CVE, nicht nur ein technischer Vollzug.
Rollback-Strategien und Ausnahmen sauber dokumentieren
Ein Rollout ohne Rollback ist kein professioneller Prozess, sondern ein Hoffnungsschimmer. Wenn ein Kernel-Patch einen Treiber bricht, ein ERP-Client nach einem .NET-Update seine Lizenzprüfung verliert oder eine VoIP-Firmware Telefone lahmlegt, hilft kein gutes Bauchgefühl. Dann braucht es eine dokumentierte Rückfallstrategie, die im Ernstfall nicht erst improvisiert wird.
Drei Rückfallwege, die in der Praxis tragen
Der erste Weg ist der Snapshot vor dem Wartungsfenster, etwa über Hyper-V, VMware oder ein Backup-Verfahren mit Wiederherstellungsprüfung. Der zweite Weg ist ein sauberer Deinstallationspfad über das Installationspaket selbst, also ein Update, das auch wieder zurückgenommen werden kann. Der dritte Weg ist ein versioniertes Golden Image für Konfigurationen, wenn nicht nur Software, sondern ganze Systemzustände betroffen sind.
Praktischer Grundsatz: Wer Updates verteilt, muss auch die Rückkehr auf den letzten stabilen Stand beherrschen.
Ausnahmen brauchen Pflichtfelder
Ausnahmen sind nicht das Problem. Das Problem ist eine Ausnahme ohne Ende, ohne Begründung und ohne Überprüfung. Deshalb gehören in jede Ausnahmeliste mindestens Begründung, Risiko, Genehmiger, Review-Datum, CVE-Bezug und eine kompensierende Kontrolle. Solche Einträge sollten spätestens alle 90 Tage oder bei neuer CVE-Bewertung geprüft werden.
In der Praxis haben sich drei Pflichtfragen bewährt:
- Warum wird nicht gepatcht?
- Welche Kontrolle senkt das Restrisiko?
- Wann wird die Entscheidung neu bewertet?
Wer diese Antworten nicht schriftlich festhält, produziert keinen Ausnahmeprozess, sondern eine offene Baustelle. Für NIS2-nahe Organisationen ist das besonders heikel, weil die Nachweislogik eben nicht nur auf „wir haben gehandelt“ setzt, sondern auf „wir können zeigen, was, wann, warum und mit welchem Ergebnis passiert ist“.
Monitoring NIS2 Nachweis und der 90 Tage Startplan
NIS2 verlangt nicht nur saubere Maßnahmen, sondern auch saubere Belege. Im Audit oder nach einem Vorfall zählt, ob ein Unternehmen zeigen kann, was geändert wurde, wann es geändert wurde und warum die Entscheidung so gefallen ist. Ein Patch Management Server ist deshalb erst dann wirklich nützlich, wenn er Updates nicht nur verteilt, sondern jeden Schritt revisionssicher protokolliert.
Welche Nachweise wirklich zählen
Die Schwachstellenlage bleibt dynamisch. Wer Patches nur monatlich plant, verpasst bei kritischen CVEs schnell den Anschluss. Der Nachweis muss deshalb abbilden, wie eine Schwachstelle erkannt, priorisiert, getestet und geschlossen wurde.
Ein NIS2-taugliches Reporting sollte mindestens diese Punkte enthalten:
- Zeit zwischen CVE-Veröffentlichung und Patch-Ausbringung
- Patch-Quote nach Asset-Klasse
- Dokumentierte Ausnahmen mit Begründung und Befristung
- Nachweis geschlossener kritischer CVEs innerhalb des definierten SLA-Fensters
In verteilten Umgebungen fällt oft genau das durch das Raster, was im Tagesgeschäft niemand gern anfasst, verwaiste VPN-Geräte, Altgeräte ohne klaren Owner oder Systeme mit unvollständiger Zuordnung. Im Audit sind genau diese Lücken unangenehm, weil sie weder technisch noch organisatorisch sauber erklärt werden können.
Ein 90-Tage-Startplan, der wirklich machbar ist
| Phase / Zeitraum | Kernziel | Liefergegenstand | NIS2-Nachweis |
|---|---|---|---|
| Woche 1 bis 2 | Bestand klären | Asset-Inventar, Kritikalitätsklassen, Eigentümer | Übersicht aller relevanten Systeme und Zuständigkeiten |
| Woche 3 bis 4 | Rollout vorbereiten | Testgruppe, Wartungsfenster, Freigabeweg | Dokumentierter Test- und Freigabeprozess |
| Woche 5 bis 8 | Produktiv ausrollen | Pilot-Ring, breiter Rollout, Rollback-Probe | Rollout-Protokolle und Rückfallnachweise |
| Woche 9 bis 12 | Betrieb stabilisieren | Monitoring, Reporting, erste Audit-Unterlagen | Wöchentliche Berichte, Ausnahme- und SLA-Nachweise |
Für die technische Sicht auf Korrelation und Überwachung hilft ein SIEM-Lösungsüberblick. Wer Patch-Status und Sicherheitsereignisse gemeinsam auswertet, erkennt Abweichungen früher und kann Nachweise für betroffene CVEs sauber zusammenführen.
Am Ende zählt nicht, ob ein Update irgendwo installiert wurde. Entscheidend ist, ob das Unternehmen auf Knopfdruck zeigen kann, welche Schwachstellen geschlossen sind, welche Ausnahmen noch offen sind und wo der nächste Risikopunkt liegt.