
Montagmorgen, kurz nach sieben. In einem Handwerksbetrieb in Worms melden sich die Mitarbeitenden an, doch die Auftragsdatenbank bleibt unbrauchbar. Seit der Nacht sind Dateien verschlüsselt, das Backup ist nicht vollständig, und der Virenscanner hat keinen verwertbaren Alarm ausgelöst. Für die Geschäftsführung beginnt damit nicht nur ein IT-Problem, sondern eine Entscheidung unter Zeitdruck: Welche Systeme sind betroffen, wann begann der Vorfall, welche Daten wurden möglicherweise kopiert und muss eine Meldung erfolgen?
Solche Situationen entstehen selten ohne Vorzeichen. Phishing, ein ungepatchter Fernzugang, ein kompromittiertes Lieferantenkonto oder auffällige Anmeldungen können sich über Stunden entwickeln, bevor jemand den Schaden erkennt. IT Security Monitoring soll diese Lücke schließen. Es verbindet technische Signale mit Zuständigkeiten, Reaktionszeiten und den Nachweisen, die Unternehmen in Rheinland-Pfalz und Hessen für einen belastbaren Sicherheitsbetrieb brauchen.
Inhaltsverzeichnis
- Warum ein Handwerksbetrieb nachts keinen Alarm mehr verschläft
- Was IT Security Monitoring wirklich bedeutet
- Die drei wichtigsten Methoden im Vergleich
- Vom Alarm zur Entscheidung im SOC
- Monitoring im Dienst von NIS2 und Compliance
- Eigenbetrieb oder Managed Monitoring für KMU
- Die ersten 90 Tage mit Monitoring auf Kurs
Warum ein Handwerksbetrieb nachts keinen Alarm mehr verschläft
Der Betrieb hat eine Firewall, einen Virenscanner und ein Backup. Auf dem Papier klingt das vernünftig. In der Praxis schützt diese Kombination nur dann zuverlässig, wenn jemand erkennt, dass mehrere unauffällige Ereignisse zusammengehören.
Am Samstagabend meldet sich zunächst ein Benutzerkonto über einen Fernzugang an. Wenig später fragt ein Arbeitsplatz ungewöhnliche Namensauflösungen ab, danach startet ein Prozess, der auf dem Gerät bisher nicht beobachtet wurde. Einzelne Ereignisse wirken nicht zwingend wie ein Angriff. Ohne zentrale Auswertung bleiben sie voneinander getrennt, obwohl sie gemeinsam eine Angriffskette ergeben können.
Praktische Regel: Ein Alarm ist nur so gut wie die Information, die ihn mit anderen Ereignissen verbindet.
Am Sonntag bemerkt niemand die Abweichung. Es gibt keine Rufbereitschaft für Sicherheitsmeldungen, die Protokolle liegen in mehreren Systemen und das Endpoint-Produkt bewertet den einzelnen Prozess nicht als eindeutig schädlich. Am Montag fehlt deshalb die wichtigste Information: der zeitliche Ablauf vom ersten verdächtigen Zugriff bis zur Verschlüsselung.
Für einen regionalen Betrieb ist das besonders problematisch. Die IT wird häufig von wenigen Personen betreut, während ERP, Warenwirtschaft, Telefonie, Cloud-Dienste und Produktions- oder Auftragssysteme voneinander abhängen. Wenn die zuständige Person erst nach Arbeitsbeginn in verschiedene Konsolen schaut, ist die Erkennung bereits reaktiv. Ein Angriff kann sich zu diesem Zeitpunkt längst auf weitere Konten oder Systeme ausgebreitet haben.
Das Bundesamt für Sicherheit in der Informationstechnik beschreibt die IT-Sicherheitslage in Deutschland auch 2025 als angespannt und sieht angesichts wachsender, oft unzureichend geschützter Angriffsflächen keinen Grund zur Entwarnung. Im selben Lagebild nennt das BSI durchschnittlich 119 neue Sicherheitslücken pro Tag, ein Anstieg von 24 Prozent gegenüber dem Vorjahr. Diese Entwicklung macht deutlich, warum ein Virenscanner allein keine ausreichende Sicht auf Identitäten, Netzwerkbewegungen und Endpunktverhalten liefert. Das BSI ordnet die aktuelle Sicherheitslage kontinuierlich ein.
Der wirtschaftliche Druck verschärft die Lage. Im Bundeslagebild Cybercrime 2025 registrierte das Bundeskriminalamt 333.922 Cybercrime-Delikte in Deutschland, davon 126.034 Inlandstaten und 207.888 Taten mit Auslandsbezug. Außerdem wurde ein Schaden von 202,4 Milliarden Euro genannt, der rund 4,5 Prozent des deutschen BIP entspricht. Das BSI veröffentlicht den Lagebericht 2025 mit den zentralen Befunden zur Cybercrime-Lage.
Ein Betrieb braucht deshalb keine möglichst laute Alarmanlage, sondern eine organisierte Fähigkeit, verdächtige Vorgänge auch außerhalb der Bürozeiten zu erkennen, einzuordnen und an die richtige Person weiterzugeben. Genau an dieser Stelle beginnt professionelles Monitoring. Eine Einordnung zu organisatorischen und technischen Schutzmaßnahmen bietet auch der Bereich IT-Sicherheit für Unternehmen.
Was IT Security Monitoring wirklich bedeutet
Eine Firewall entscheidet, welche Verbindungen erlaubt sind. Ein Virenscanner sucht nach bekannten oder erkennbaren Schadmustern. Monitoring beobachtet dagegen fortlaufend, was in der Umgebung passiert, und bewertet Ereignisse im Zusammenhang.
Dafür werden Daten aus mehreren Quellen zusammengeführt. Dazu gehören beispielsweise Authentifizierungsprotokolle, VPN- und Firewall-Ereignisse, DNS-Anfragen, Cloud-Aktivitäten, Servermeldungen und Telemetrie von Endgeräten. Die Daten allein schaffen noch kein Lagebild. Erst die gemeinsame zeitliche, technische und organisatorische Einordnung macht aus Protokollen verwertbare Hinweise.
Von Rohdaten zur verwertbaren Erkenntnis
Ein Security Information and Event Management, kurz SIEM, übernimmt dabei mehrere Aufgaben. Es nimmt Ereignisse entgegen, bringt unterschiedliche Formate in eine gemeinsame Struktur und ordnet sie Systemen, Benutzern, Quellen und Zeitpunkten zu. Anschließend können Regeln einzelne Signale korrelieren.
Ein fehlgeschlagener Anmeldeversuch ist häufig harmlos. Viele fehlgeschlagene Anmeldungen, danach eine erfolgreiche Anmeldung von einem ungewöhnlichen Ort und anschließend eine privilegierte Änderung ergeben jedoch ein anderes Bild. Das SIEM ersetzt dabei nicht die Entscheidung eines Sicherheitsverantwortlichen. Es reduziert aber die Sucharbeit und liefert den Kontext, den eine Triage braucht.
Normalisierung ist wichtig, weil jede Quelle ihre Ereignisse anders benennt und strukturiert. Ohne Normalisierung muss eine Regel für jede Firewall, jeden Cloud-Dienst und jedes Betriebssystem separat gepflegt werden. Mit einer einheitlichen Darstellung können Regeln leichter angepasst und Ergebnisse besser verglichen werden.
Sammeln ist noch kein Monitoring
Ein Logserver, der alles speichert, kann im Vorfall hilfreich sein. Er entdeckt aber keinen Angriff, wenn niemand die Daten auswertet und keine Schwellenwerte, Prioritäten oder Eskalationswege hinterlegt sind. Ungefilterte Datenmengen führen im KMU schnell zu zwei Problemen: Die Speicherung wird teuer, und relevante Ereignisse gehen in irrelevanten Meldungen unter.
Monitoring braucht drei Ebenen: verlässliche Telemetrie, priorisierte Erkennung und eine erreichbare Reaktion.
Ein funktionierender Prozess definiert deshalb zuerst die schützenswerten Systeme und die wichtigsten Angriffsszenarien. Danach werden nur die Quellen angebunden, die für diese Szenarien tatsächlich Erkenntnisse liefern. Erst im nächsten Schritt entstehen Regeln, Tickets und Eskalationen.
Für die technische Basis kann ein Unternehmen klassische SIEM-Produkte, Cloud-Dienste oder eine betreute Lösung einsetzen. Entscheidend bleibt, dass die Zuständigkeit klar ist. Wer ein Ereignis bewertet, wer den betroffenen Benutzer sperren darf und wer die Geschäftsleitung informiert, muss vor dem Vorfall feststehen. Eine praktische Ergänzung zum Sicherheitsmonitoring ist das Monitoring der IT-Infrastruktur, sofern technische Überwachung und Security-Auswertung sauber voneinander abgegrenzt werden.
Die drei wichtigsten Methoden im Vergleich
Die drei gängigen Monitoring-Methoden beantworten unterschiedliche Fragen. Log-Monitoring rekonstruiert Aktionen, Netzwerk-Monitoring untersucht Kommunikation und Endpoint-Monitoring beobachtet Verhalten direkt auf Geräten. Kein Ansatz ersetzt die anderen vollständig.
Log-Monitoring eignet sich besonders für Identitäts- und Berechtigungsfragen. Es zeigt, wer sich wann angemeldet, welche Gruppenrichtlinie geändert oder welche administrative Aktion ausgeführt hat. Seine Schwäche liegt dort, wo Systeme unvollständig protokollieren, Zeitquellen auseinanderlaufen oder wichtige Cloud- und SaaS-Ereignisse nicht eingebunden sind.
Netzwerk-Monitoring liefert eine andere Perspektive. Ungewöhnliche DNS-Anfragen, neue externe Kommunikationsziele oder Bewegungen zwischen VLANs können sichtbar werden, selbst wenn der betroffene Endpoint keine eindeutige Meldung erzeugt. Verschlüsselte Verbindungen und fehlende Sichtbarkeit in Cloud-Umgebungen begrenzen allerdings die Aussagekraft.
Endpoint-Monitoring mit EDR-Agenten beobachtet Prozesse, Speicherzugriffe, Registry-Änderungen und lokale Aktivitäten. Dadurch erkennt es Verhalten, das auf Netzwerkebene verborgen bleibt. Dafür müssen Agenten auf den Geräten funktionieren, gepflegt werden und ihre Meldungen in den Arbeitsablauf der IT passen.
| Methode | Erkenntnisziel | Typische Datenquellen | Blinde Flecken | Eignung KMU |
|---|---|---|---|---|
| Log-Monitoring | Nachvollziehen, wer welche Aktion ausgeführt hat | Active Directory, Microsoft 365, VPN, Firewalls, Server | Fehlende oder uneinheitliche Protokolle, geringe Aussage ohne Kontext | Gute Grundlage für Identitäts- und Compliance-Fragen |
| Netzwerk-Monitoring | Erkennen ungewöhnlicher Kommunikation und Bewegungen | Firewalls, DNS, NetFlow, VLANs, Cloud-Netzwerke | Verschlüsselung, externe Cloud-Dienste, nicht erfasste Segmente | Sinnvoll bei verteilten Standorten und Produktionsnetzen |
| Endpoint-Monitoring | Beobachten verdächtiger Prozesse und lokaler Änderungen | EDR-Agenten, Betriebssysteme, Server, Arbeitsplätze | Agent-Ausfälle, mobile Geräte, Betriebsaufwand | Besonders wertvoll für Arbeitsplatz- und Server-Schutz |
Ein Produktionsunternehmen mit getrennten Netzen braucht meist mehr Netzwerktransparenz als ein kleiner Bürobetrieb. Eine Klinik oder ein Sozialträger muss dagegen Identitäten, privilegierte Zugriffe und verteilte Endgeräte konsequent einbeziehen. Die richtige Auswahl richtet sich daher nach den wichtigsten Risiken, nicht nach der längsten Feature-Liste.
Ein SIEM kann die drei Perspektiven verbinden, wenn die Quellen sinnvoll ausgewählt und Regeln betreut werden. Bei der Auswahl und dem Betrieb einer SIEM-Lösung sollte ein KMU deshalb nicht nur nach der Plattform fragen, sondern auch nach Datenqualität, Zuständigkeit, Alarmbearbeitung und Nachweisführung.
Vom Alarm zur Entscheidung im SOC
Ein Alert ist zunächst nur ein Hinweis. Ein SOC, intern oder extern, muss daraus eine belastbare Entscheidung machen. Dazu gehört die Prüfung, ob das Ereignis echt, relevant und akut ist.
Der Ablauf beginnt mit dem Rohsignal. Die Triage ergänzt Benutzer, Gerät, Standort, vorherige Ereignisse und den betroffenen Geschäftsprozess. Danach folgt die Bewertung: Handelt es sich um Fehlbedienung, eine technische Störung, eine erwartbare Änderung oder einen Sicherheitsvorfall? Erst dann wird eskaliert oder geschlossen.
Ein belastbarer Arbeitsablauf
Ein kleines SOC braucht dafür keine komplizierte Organisation, aber klare Regeln:
- Triage: Ein Analyst prüft das Ereignis anhand definierter Kriterien und dokumentiert die Entscheidung.
- Anreicherung: Systeme, Benutzer, Schwachstellen, aktuelle Änderungen und bekannte Wartungsfenster werden verknüpft.
- Eskalation: Kritische Fälle gehen an eine festgelegte interne oder externe Rufbereitschaft.
- Reaktion: Das Playbook beschreibt etwa Kontosperrung, Geräteisolierung, Beweissicherung und Wiederanlauf.
- Abschluss: Ursache, Maßnahmen, Verantwortliche und offene Risiken werden im Ticket festgehalten.
Die besten Kennzahlen messen nicht die Lautstärke des Systems. Eine hohe Zahl verarbeiteter Events kann sogar auf schlechte Filterung hindeuten. Aussagekräftiger sind die Zeit bis zur Erkennung, die Zeit bis zur Reaktion, der Anteil echter Fehlalarme und der Anteil fristgerecht abgeschlossener Vorgänge.
| KPI | Was sie misst | Typischer Zielwert KMU | Aussagekraft |
|---|---|---|---|
| Mean Time to Detect | Zeit vom relevanten Ereignis bis zur Erkennung | Im eigenen Prozess festlegen | Zeigt, ob Überwachung tatsächlich früh erkennt |
| Mean Time to Respond | Zeit von der Bestätigung bis zur Reaktion | Nach Kritikalität staffeln | Macht Reaktionsfähigkeit sichtbar |
| False-Positive-Quote | Anteil falsch bewerteter Alarme | Regelmäßig reduzieren | Zeigt, ob Regeln praxistauglich sind |
| Abschluss innerhalb definierter SLAs | Anteil fristgerecht bearbeiteter Tickets | Für Prioritäten festlegen | Misst Prozessdisziplin und Dienstleisterleistung |
Ein guter KPI beantwortet eine Managementfrage. Die reine Event-Anzahl beantwortet sie nicht.
Für KMU ist die Übergabe entscheidend. Die interne IT kennt Anlagen, Benutzer und Geschäftsprozesse. Ein externer Dienstleister kann dagegen ausserhalb der Bürozeiten überwachen und standardisierte Playbooks bereitstellen. Beide Seiten müssen dieselbe Sprache, dieselben Prioritäten und dieselben Kontaktdaten verwenden.
Monitoring im Dienst von NIS2 und Compliance
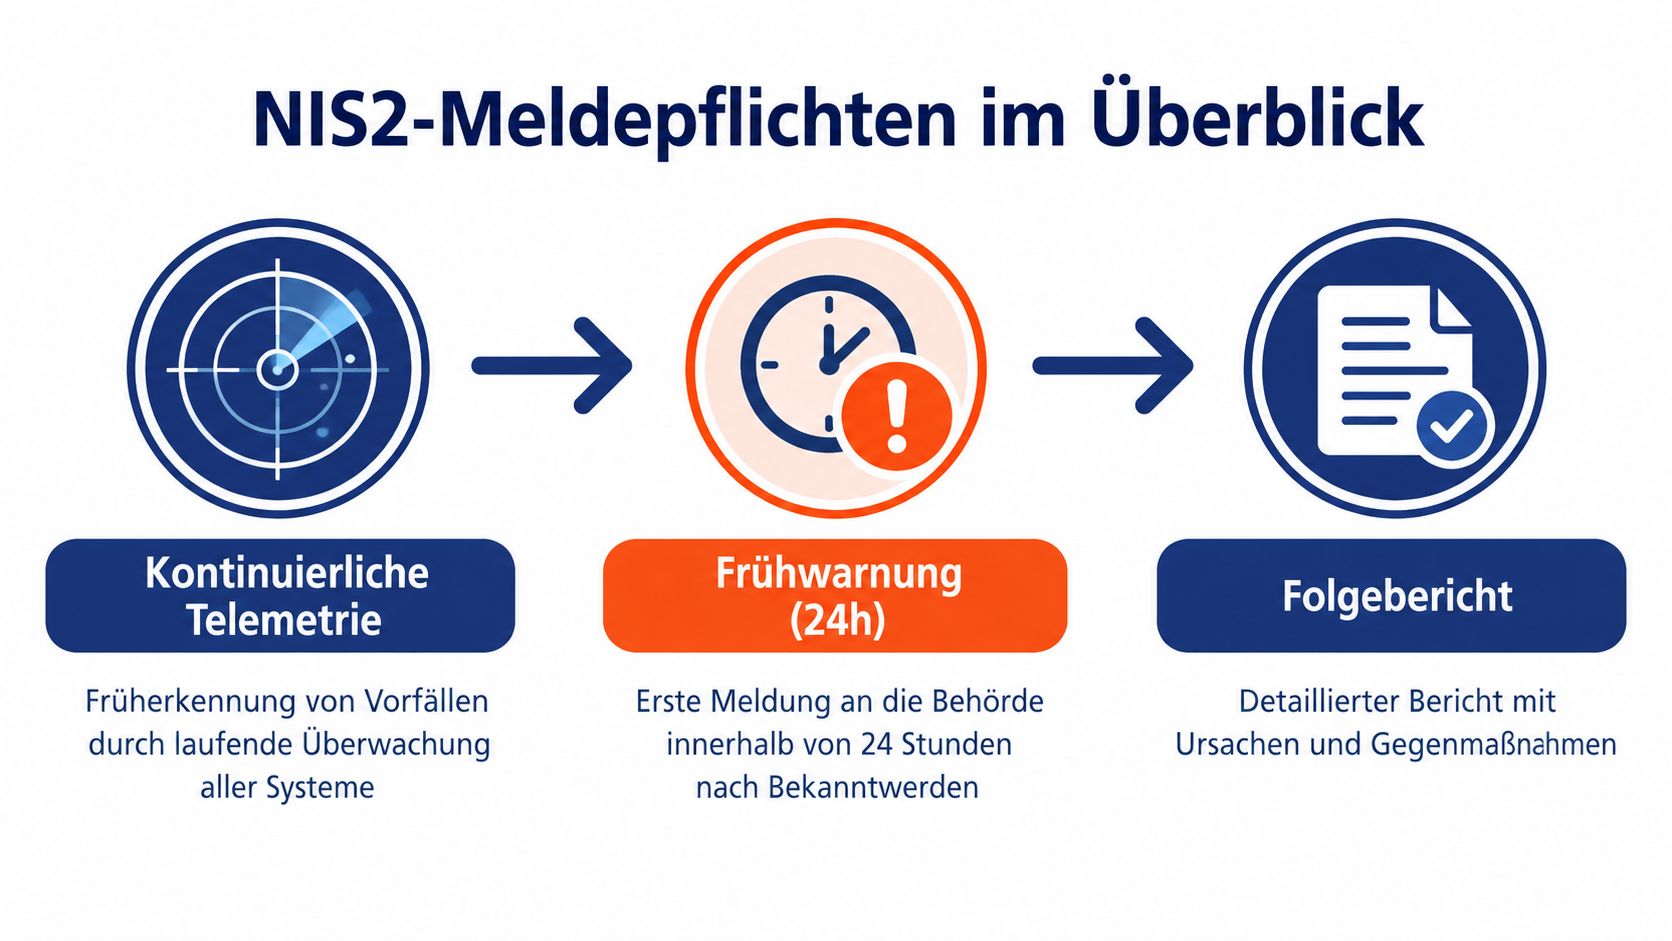
NIS2 verändert die Bedeutung von Monitoring. Es geht nicht nur darum, einen Angriff möglichst früh zu sehen. Ein Unternehmen muss im Ernstfall auch nachvollziehbar erklären können, wann der Vorfall bekannt wurde, welche Systeme betroffen sind, wie die Bewertung erfolgte und welche Maßnahmen eingeleitet wurden.
Für die deutsche NIS2-Umsetzung werden rund 29.500 Einrichtungen neuen Pflichten zugeordnet. Dazu gehören unter anderem die Registrierung beim BSI, die Meldung erheblicher Sicherheitsvorfälle sowie technische und organisatorische Risikomassnahmen. Das Meldeverfahren sieht eine Erstmeldung innerhalb von 24 Stunden, eine Folgemeldung innerhalb von 72 Stunden und einen Abschlussbericht nach einem Monat vor. Die rechtlichen Auswirkungen des neuen BSI-Gesetzes werden in dieser Einordnung zur NIS2-Umsetzung beschrieben.
Welche Nachweise im Alltag zählen
Ein KMU sollte die Nachweise nicht erst während eines Vorfalls zusammensuchen. Für die wichtigsten Systeme müssen Protokolle, Zeitstempel und Quellinformationen verlässlich verfügbar sein.
- Authentifizierung: Erfolgreiche und fehlgeschlagene Anmeldungen, privilegierte Aktionen, Kontoänderungen und relevante Identitätsereignisse.
- Fernzugänge: VPN-Anmeldungen, Gerätebezug, Sitzungszeiten und administrative Aktivitäten.
- Netzwerkgrenzen: Firewall-Entscheidungen, ungewöhnliche Verbindungen, DNS-Aktivitäten und Bewegungen zwischen kritischen Segmenten.
- Endpunkte: Prozessstarts, Malware-Meldungen, Geräteisolierungen, lokale Änderungen und Status des EDR-Agenten.
- Cloud-Dienste: Anmeldeereignisse, Konfigurationsänderungen, Datenzugriffe und Aktivitäten privilegierter Konten.
- Zeitbezug: Einheitliche Zeitquellen, nachvollziehbare Zeitzonen und unveränderte Aufbewahrung der Originalereignisse.
Diese Daten müssen nicht sämtlich dauerhaft an dieselbe Stelle fliessen. Sie müssen aber auffindbar, vor Manipulation geschützt und mit einem Verantwortlichen verknüpft sein. Eine Meldekette ohne dokumentierte Zeitpunkte erzeugt unnötige Unsicherheit, gerade wenn Geschäftsleitung, IT, Datenschutz und externe Incident-Response-Partner schnell zusammenarbeiten müssen.
Das BSI betreibt seit Februar 2024 ein 24/7 Nationales IT-Lagezentrum, das Beobachtungen und Vorkommnisse kontinuierlich bewertet. Für Unternehmen folgt daraus eine praktische Lehre: Sicherheitsverantwortung endet nicht mit dem Büroschluss. Der BSI-Lagebericht erläutert die kontinuierliche Lagebewertung und die Anforderungen an eine dauerhafte Beobachtung.
Monitoring unterstützt ausserdem die Risikobewertung nach NIS2 Art. 21. Es zeigt, ob Schutzmassnahmen funktionieren, welche Systeme besonders exponiert sind und wo Erkennung oder Reaktion Lücken aufweisen. Der BSI-Lagebericht 2024 nennt rund 38,6 Millionen offene oder verwundbare Server-Dienste sowie 3.814 Meldungen aus dem Warn- und Informationsdienst. Die Angaben des BSI zur offenen Angriffsfläche und zur Warnlage finden sich im Lagebericht 2024.
Eigenbetrieb oder Managed Monitoring für KMU
Ein eigenes Monitoring klingt zunächst kontrollierbar. Die Daten bleiben im Unternehmen, Anpassungen lassen sich direkt mit internen Prozessen verbinden, und die IT kennt die Umgebung. Der Preis dafür ist organisatorisch: jemand muss Regeln pflegen, Alarme bewerten, Vertretungen organisieren und auch nachts, am Wochenende oder an Feiertagen reagieren.
Viele KMU in Hessen und Rheinland-Pfalz arbeiten mit kleinen IT-Teams. Diese Teams können Infrastruktur und Benutzerbetrieb gut abdecken, aber eine durchgehende Security-Bereitschaft lässt sich nicht nebenbei versprechen. Ein Eigenbetrieb funktioniert, wenn Verantwortlichkeiten, Qualifikationen, Werkzeuge und Vertretungen realistisch geplant sind.
Managed Monitoring nimmt einen Teil dieser Last ab. Ein Dienstleister kann standardisierte Erkennung, eine besetzte Alarmannahme und definierte Eskalationen anbieten. Das reduziert jedoch nicht automatisch jedes Risiko. Die interne IT muss weiterhin Kontext liefern, Änderungen melden und Reaktionen freigeben.
| Kriterium | Eigenbetrieb | Managed Monitoring |
|---|---|---|
| Kosten | Investitionen und laufender Personalaufwand liegen intern | Planbare laufende Kosten, abhängig von Umfang und Vertrag |
| Reaktionszeit | Abhängig von Bereitschaft und Auslastung des Teams | Nach vereinbartem Serviceumfang und Eskalationsmodell |
| 24/7-Abdeckung | Nur mit eigener Rufbereitschaft realistisch | Kann Bestandteil des Dienstes sein |
| Umgebungswissen | Direkt bei der internen IT vorhanden | Muss strukturiert übergeben und gepflegt werden |
| Datenhoheit | Interne Kontrolle über Plattform und Zugriffe | Vertragliche Regelung zu Datenstandort und Zugriff erforderlich |
| Abhängigkeit | Abhängigkeit von eigenen Schlüsselpersonen | Abhängigkeit vom Anbieter und seinen Betriebsprozessen |
| Flexibilität | Änderungen können schnell intern umgesetzt werden | Änderungen brauchen abgestimmte Verantwortlichkeiten |
Bei einem externen Partner gehören EU-Datenstandort, klare Eskalationswege, definierte SLAs und transparente Kostenmodelle auf die Prüfliste. Ebenso wichtig sind Fragen nach Log-Aufbewahrung, Rollenmodellen, Exit-Szenarien und der Unterstützung bei einer NIS2-Meldung.
Die Entscheidung sollte nicht mit der Frage beginnen, welches Produkt gekauft wird. Besser ist eine Bestandsaufnahme: Welche Systeme müssen jederzeit sichtbar sein, wer nimmt kritische Alarme an und welche Reaktion darf automatisiert erfolgen? Erst daraus ergibt sich, ob ein begrenzter Eigenbetrieb, ein hybrides Modell oder ein Managed SOC passt.
Die ersten 90 Tage mit Monitoring auf Kurs
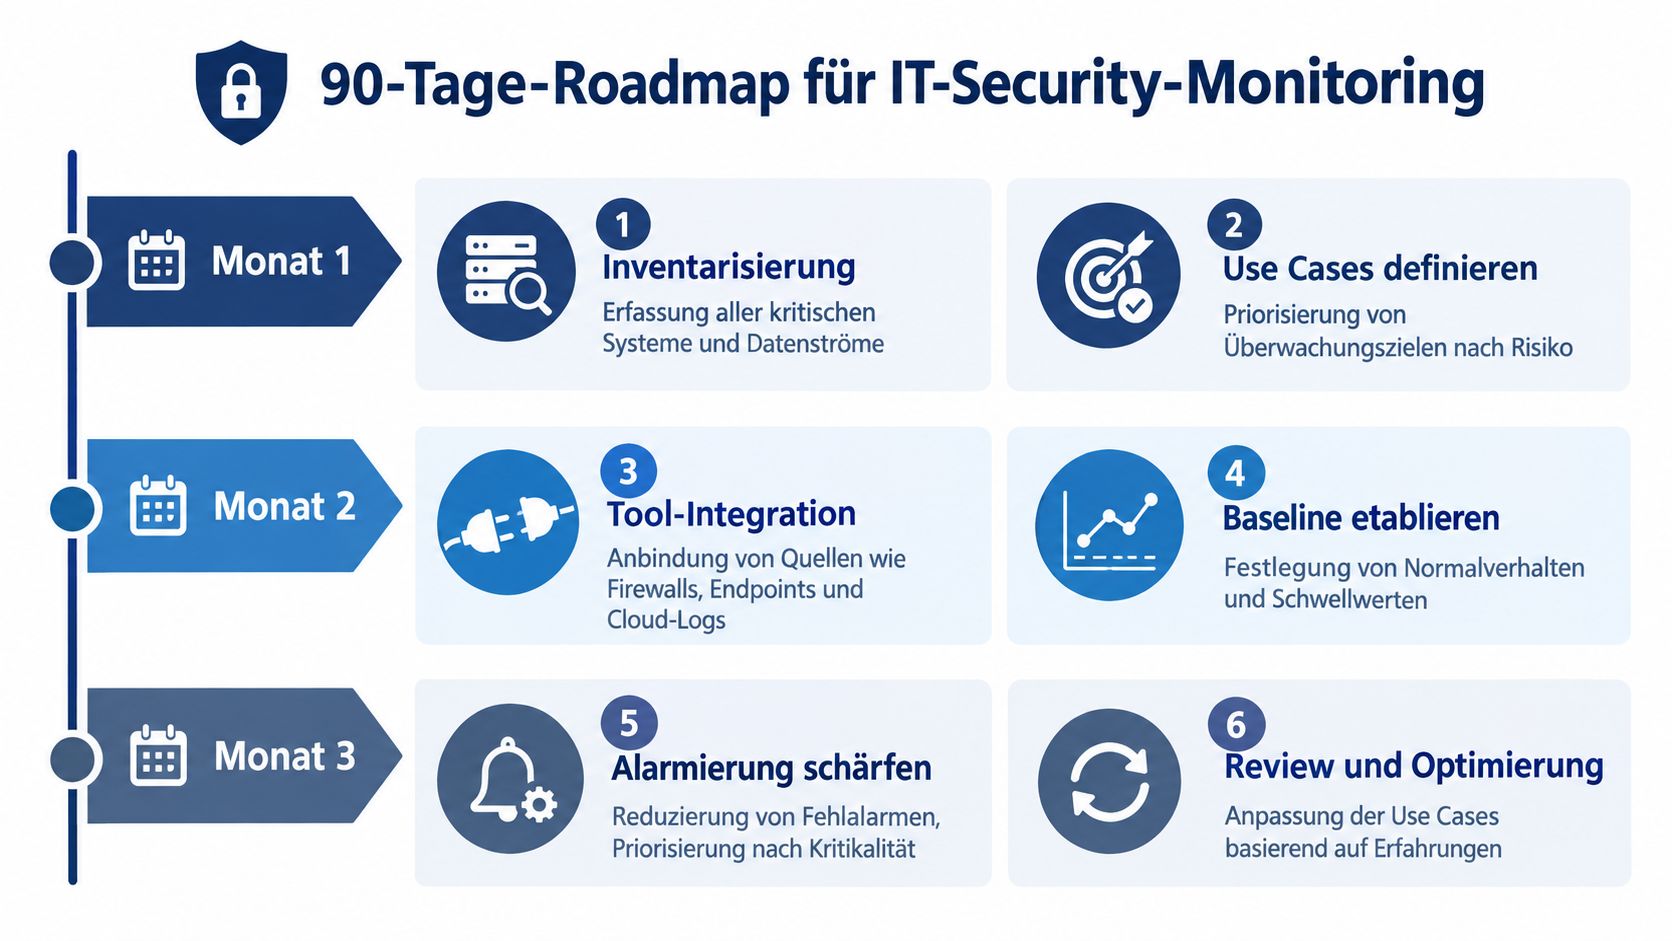
Ein Monitoring-Projekt scheitert selten daran, dass es zu wenige Datenquellen gibt. Häufig fehlen Prioritäten. Deshalb beginnt die Einführung nicht mit dem Kauf einer Plattform, sondern mit der Frage, welche Systeme und Ereignisse für den Betrieb, die Sicherheit und die Meldefähigkeit entscheidend sind.
Monat eins mit Übersicht und Priorität
Zuerst entsteht eine belastbare Inventarisierung. Dazu gehören Identitätsdienste, zentrale Server, Firewalls, Fernzugänge, Cloud-Dienste, Backups, Produktionssysteme und besonders schützenswerte Daten. Parallel definiert das Team konkrete Use Cases, etwa ungewöhnliche privilegierte Anmeldungen, Deaktivierung eines Schutzagenten, auffällige Verschlüsselungsaktivitäten oder Änderungen an kritischen Konfigurationen.
Am Ende dieser Phase sollte feststehen, welche Quellen zuerst angebunden werden. Ein KMU mit 50 bis 200 Endpunkten braucht nicht zwangsläufig eine maximal komplexe Plattform. Eine solide Kombination aus zentraler Protokollierung, EDR, Firewall- und Identitätsdaten kann als Anfang genügen, wenn jemand die Meldungen bewertet und die Regeln pflegt.
Monat zwei mit Daten und Baseline
Im zweiten Monat werden die priorisierten Quellen integriert. Dabei prüft das Team nicht nur, ob Ereignisse ankommen, sondern auch, ob Benutzer, Geräte und Zeitstempel korrekt zugeordnet werden. Danach wird ein Normalverhalten für wichtige Systeme gebildet, damit ungewöhnliche Aktivitäten nicht allein nach starren Signaturen bewertet werden.
Die erste Messung sollte einfach bleiben: Zeit bis zur ersten Sichtung, Mean Time to Detect und Anteil dokumentierter Alarme. Diese Werte dienen zunächst als Ausgangspunkt. Sie zeigen, ob das System überhaupt bearbeitbare Hinweise liefert.
Ein kleiner Satz sauberer Use Cases ist besser als eine grosse Sammlung ungeprüfter Regeln.
Monat drei mit Reaktion und Probe
Im dritten Monat werden Fehlalarme reduziert und die Eskalationskette getestet. Für kritische Ereignisse braucht es ein Playbook mit Zuständigkeiten, Kontaktdaten, Freigaben und Rückfalloptionen. Dazu gehören auch Rollback-Pläne, falls eine automatische Isolation oder Kontosperrung einen legitimen Geschäftsprozess beeinträchtigt.
Eine Probe-Meldung für einen angenommenen Sicherheitsvorfall macht Lücken sichtbar. Das Team sollte dabei prüfen, ob die Ereigniszeit, die betroffenen Systeme, die erste Bewertung, die eingeleiteten Maßnahmen und die Kommunikationswege dokumentiert werden können. Genau diese Übung trennt ein technisch installiertes Monitoring von einem belastbaren Sicherheitsprozess.
Für ein Unternehmen mit kleiner IT-Abteilung ist der Wechsel zu einem SOC-Partner sinnvoll, wenn die Alarmannahme ausserhalb der Arbeitszeit nicht gewährleistet ist, mehrere Standorte oder Cloud-Umgebungen zusammengeführt werden müssen oder die NIS2-Nachweisführung intern nicht zuverlässig gelingt. Der Partner ersetzt dabei nicht die Verantwortung des Unternehmens. Er erweitert die verfügbare Beobachtung und strukturiert die Reaktion.
Ein kurzer Überblick zur praktischen Umsetzung kann als Ergänzung dienen:
Nach den ersten 90 Tagen beginnt die eigentliche Pflege. Neue Systeme, Cloud-Dienste und Geschäftsprozesse verändern das Normalverhalten. Regeln müssen deshalb regelmäßig überprüft, Alarme nachbearbeitet und Eskalationswege mit den Verantwortlichen abgestimmt werden.
GSL Groß GmbH unterstützt KMU mit proaktivem Monitoring, SIEM-orientierter Auswertung, Security-Checks und Beratung zu NIS2 sowie IT-Risikomanagement. Besprechen Sie Ihre wichtigsten Systeme, vorhandenen Logquellen und die gewünschte Reaktionsabdeckung mit GSL Groß GmbH, und starten Sie mit einer priorisierten Monitoring-Bestandsaufnahme statt mit einer unübersichtlichen Tool-Sammlung.