
Montagmorgen im Hunsrück: Die VPN-Verbindung zur Zentrale fällt aus, die Produktionsdaten des Schwesterwerks stehen, und im Unternehmen merkt es zunächst niemand. Erst der Anruf eines Kunden bringt Bewegung in die Sache. Die IT sucht manuell in Firewall, Servern und Anwendungen nach der Ursache, während Maschinen, Mitarbeitende und Termine weiter auf Daten warten.
Genau solche Situationen zeigen, warum IT-Infrastruktur-Monitoring für KMU kein Komfortfeature mehr ist. Hybride Arbeitsplätze, Cloud-Dienste, virtualisierte Server, Produktionssysteme und verteilte Standorte vergrössern die IT-Fläche. Ohne zentrale Überwachung bleibt unklar, ob ein Dienst wirklich verfügbar ist, ob sich ein Sicherheitsereignis anbahnt oder ob die Speicherkapazität in wenigen Tagen kritisch wird.
Für Unternehmen in Rheinland-Pfalz und Hessen kommt die regulatorische Seite hinzu. Das BSI beobachtet die IT-Sicherheitslage kontinuierlich, veröffentlicht regelmässige Lageberichte und monatliche Lagebilder und wurde durch das IT-Sicherheitsgesetz 2.0 bei der Detektion und Abwehr von Sicherheitslücken gestärkt. Der BSI-Lagebericht macht damit deutlich, dass Monitoring Teil einer nationalen Sicherheitsarchitektur geworden ist.
Inhaltsverzeichnis
- Warum IT Infrastruktur Monitoring für KMU jetzt Pflicht ist
- Vom Log zum Steuerungsinstrument
- Die vier Beobachtungsdomänen im Überblick
- Alerting das wirklich ankommt
- Tool-Typen und Auswahlkriterien für KMU
- Monitoring im Spannungsfeld von NIS-2 und BSI
- Monitoring als Teil von Managed Services
- Best Practices für Einführung und Betrieb
Warum IT Infrastruktur Monitoring für KMU jetzt Pflicht ist
Ein Ausfall ist selten nur ein technisches Problem. Wenn die Authentifizierung nicht funktioniert, kommen Mitarbeitende nicht an Anwendungen. Wenn die Standortverbindung instabil ist, fehlen Produktionsdaten. Wenn ein Backup-Job still scheitert, entsteht ein Risiko, das erst beim Wiederherstellungsversuch sichtbar wird. Monitoring schafft die notwendige Vorwarnung, bevor aus einer Abweichung ein Betriebsstillstand wird.
Die wirtschaftliche Dimension lässt sich nicht wegdiskutieren. Eine aktuelle Auswertung berichtet für deutsche Unternehmen jährliche Gesamtkosten schwerwiegender IT-Ausfälle von rund 147 Millionen Euro. Betroffene Unternehmen beziffern den Schaden im Mittel auf 1,7 Millionen Euro pro Ausfallstunde, während 46 Prozent der deutschen Befragten mindestens wöchentlich einen gravierenden Ausfall melden. Diese Angaben stammen aus der Auswertung zu IT-Ausfallkosten und Observability.
Was Monitoring im Alltag leisten muss
Ein brauchbares System beantwortet nicht nur die Frage, ob ein Server erreichbar ist. Es muss zeigen:
- Verfügbarkeit: Sind VPN, ERP, Dateifreigaben und zentrale Cloud-Dienste nutzbar?
- Leistung: Steigen Latenz, Fehlerquote oder Speicherdruck bereits vor einem Ausfall?
- Sicherheit: Gibt es ungewöhnliche Anmeldeversuche, Adminzugriffe oder Konfigurationsänderungen?
- Nachweisbarkeit: Wer hat wann welchen Alarm gesehen, bewertet und bearbeitet?
Das BSI fordert im IT-Grundschutz, alle IT-Komponenten in ein einheitliches IT-Monitoring einzubinden, relevante Parameter zu überwachen, passende Schwellwerte zu definieren und regelmässige Reports für Lage- und Trendbewertungen zu erstellen. Die BSI-Anforderungen an IT-Monitoring machen aus Monitoring ein Steuerungsinstrument für Service-Management, Kapazitätsplanung und Ursachenanalyse.
Praktische Regel: Wer heute keine verlässliche Überwachung betreibt, betreibt seine IT nicht aktiv. Er verwaltet ein Risiko und wartet auf den nächsten Hinweis von aussen.
NIS-2 verstärkt diesen Druck. Das deutsche Umsetzungsgesetz trat am 6. Dezember 2025 in Kraft, die Registrierungsfrist endete am 6. März 2026. Laut der im Umfeld des BSI zitierten Angabe erfüllten nur rund 38 Prozent der erwarteten Unternehmen ihre Registrierungspflicht, wie Security Insider zur deutschen NIS-2-Umsetzung berichtet. Diese Lücke zeigt: Formale Registrierung und operativer Betrieb liegen vielerorts noch auseinander. Monitoring muss deshalb nicht nur Alarme senden, sondern Vorfälle erkennen, Zuständigkeiten abbilden und Nachweise liefern.
Vom Log zum Steuerungsinstrument
Viele KMU starten mit Logdateien, weil fast jedes System bereits Meldungen erzeugt. Das allein reicht nicht. Eine Datei, die niemand regelmässig auswertet, erkennt keinen Vorfall und verhindert keinen Ausfall.
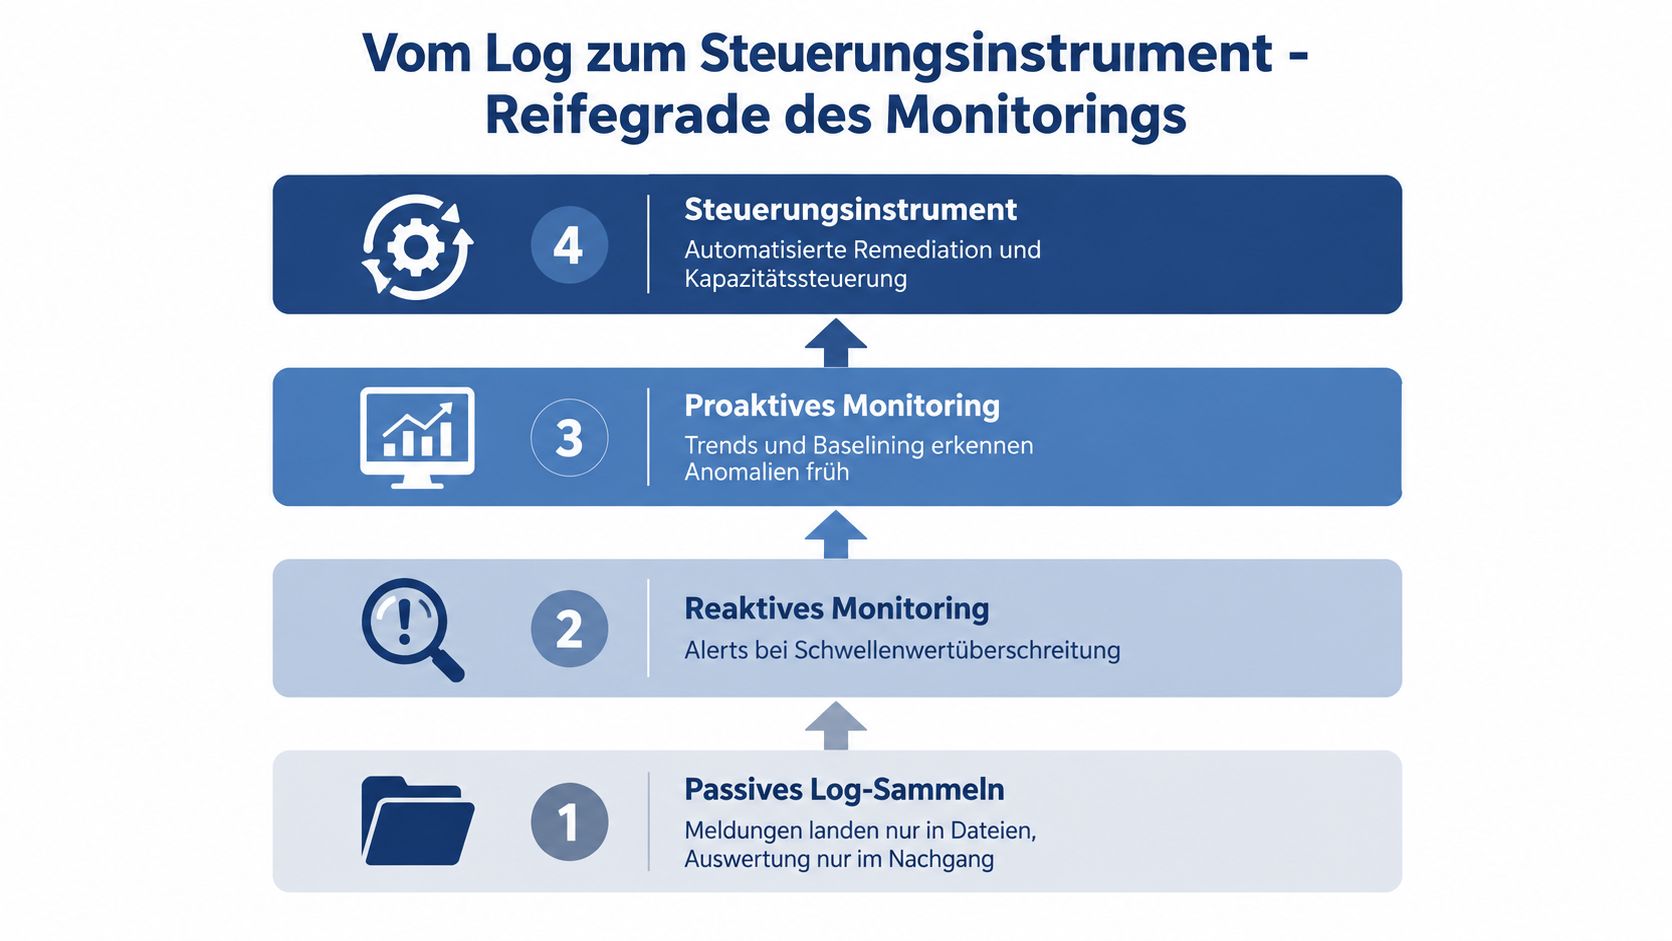
Vier Reifegrade, die in der Praxis zählen
Stufe eins, passives Log-Sammeln: Meldungen landen in lokalen Dateien oder einzelnen Konsolen. Das genügt für eine nachträgliche Fehlersuche bei kleinen, überschaubaren Umgebungen. Für Sicherheitsereignisse mit kurzer Reaktionszeit ist dieser Ansatz zu langsam.
Stufe zwei, reaktives Monitoring: Das System prüft Erreichbarkeit, Dienste und Schwellwerte. Bei einer Grenzwertverletzung geht eine E-Mail an eine zuständige Person. Das ist ein sinnvoller Einstieg für Server, Firewalls, Switches und zentrale Anwendungen, solange die Alarmregeln gepflegt werden.
Stufe drei, proaktives Monitoring: Metriken werden über Zeit verglichen. CPU-Auslastung, RAM, Disk-I/O, Latenz, Fehlerquoten und Verfügbarkeit ergeben zusammen ein Bild. Baselines helfen dabei, ungewöhnliche Muster zu erkennen, ohne jede kurzfristige Schwankung zum Incident zu erklären.
Stufe vier, Observability: Logs, Metriken und Traces werden korreliert. Das ist besonders bei komplexen Anwendungen und Cloud-Abhängigkeiten hilfreich, weil Teams nicht nur ein Symptom sehen, sondern die wahrscheinliche Ursache verfolgen können. Für ein klassisches Produktions-KMU ist diese Stufe nicht automatisch nötig. Sie lohnt sich, wenn viele Dienste zusammenwirken und interne Entwickler- oder DevOps-Kompetenz vorhanden ist.
Der Sprung zur nächsten Stufe braucht keine riesige Plattform, sondern klare Prioritäten. Beginnen Sie mit den Diensten, deren Ausfall direkt Umsatz, Produktion oder Patientenversorgung beeinträchtigt. Ergänzen Sie danach die Signale, die bei echten Störungen in der Vergangenheit gefehlt haben.
Für die strukturierte Auswertung von Ereignissen kann ein eigenes Log-Management für zentrale Protokolle sinnvoll sein. Entscheidend ist nicht die Menge der gespeicherten Daten, sondern die Verbindung zu Alarmierung, Verantwortlichkeit und dokumentierter Reaktion.
Ein kurzer Überblick per Video kann die Unterschiede zwischen klassischem Monitoring und weiterführender Observability veranschaulichen:
Die vier Beobachtungsdomänen im Überblick
Ein KMU braucht keine Überwachung jedes verfügbaren Zählers. Es braucht eine belastbare Sicht auf die Bereiche, die Geschäftsprozesse tragen. In der Praxis gehören Netzwerk, Server, Endpunkte und Logs in einen gemeinsamen Monitoring-Rahmen.
Netzwerk
Beim Netzwerk zählen nicht nur Online- oder Offline-Zustände. Bandbreite, Latenz, Paketverlust und DNS-Gesundheit zeigen, ob eine Anwendung aus Sicht des Standorts tatsächlich funktioniert. Switches, Firewalls, Access Points und Drucker liefern über SNMP technische Zustände, während Flow-Daten Verkehrsströme und ungewöhnliche Muster sichtbar machen können.
Server und Virtualisierung
Server-Monitoring sollte CPU, RAM, Disk-I/O, freien Speicher und Hardwarezustände erfassen. In virtualisierten Umgebungen kommen Hypervisor- und VM-Auslastung hinzu. Ein einzelner überlasteter Host kann mehrere Geschäftsdienste beeinträchtigen, obwohl die einzelnen virtuellen Maschinen zunächst unauffällig wirken.
Endpunkte und IoT
Arbeitsplätze, Notebooks, mobile Geräte und IoT-Komponenten gehören in die Betrachtung. Patch-Stand, Gerätestatus, ungewöhnliche Ressourcennutzung und fehlgeschlagene Anmeldungen liefern Hinweise, die ein reines Server-Dashboard nicht zeigt. Netzwerkdrucker, Kameras und andere Geräte sollten mindestens auf Erreichbarkeit und auffällige Zustände geprüft werden.
Logs
Logs ergänzen Metriken um Kontext. Authentifizierungsfehler, Adminzugriffe, Firewall-Ereignisse und Applikationsfehler können sicherheitsrelevant sein, auch wenn CPU und Netzwerk völlig normal aussehen. Ein gutes System sammelt diese Ereignisse zentral, filtert bekannte Routinefälle und leitet relevante Signale an Ticketing oder Bereitschaft weiter.
| Domäne | Kernmetriken | Typische Datenquellen | Beispiel-Tools |
|---|---|---|---|
| Netzwerk | Bandbreite, Latenz, Paketverlust, DNS-Gesundheit, Schnittstellenfehler | Switches, Firewalls, Router, SNMP, Flow-Daten | PRTG, Zabbix, Icinga |
| Server | CPU, RAM, Disk-I/O, Speicherplatz, Temperatur, Dienststatus | Agenten, WMI, SSH, Hypervisor-APIs | Nagios, PRTG, Icinga |
| Endpunkte | Erreichbarkeit, Patch-Stand, Anmeldefehler, Ressourcennutzung | Arbeitsplatzgeräte, Notebooks, MDM, Endpoint-Agenten | Endpoint-Management, RMM-Plattformen |
| Logs | Authentifizierung, Adminaktionen, Firewall-Events, Applikationsfehler | Betriebssysteme, Firewalls, Anwendungen, Cloud-Dienste | SIEM, zentrale Log-Management-Systeme |
Managed Services sind dort sinnvoll, wo die Daten kontinuierlich geprüft werden müssen, aber kein eigenes Team rund um die Uhr verfügbar ist. Das gilt besonders für verteilte Standorte, Produktionsnetze und Einrichtungen mit erhöhten Dokumentationsanforderungen.
Alerting das wirklich ankommt
Monitoring scheitert selten an fehlenden Daten. Es scheitert an Alerts, die niemand ernst nimmt. Ein Postfach voller Warnungen erzeugt keine Sicherheit, sondern verschiebt die Störung in den nächsten Arbeitstag.
Schwellwerte mit Geschäftsbezug
Statische Grenzwerte sind für viele KMU ein guter Anfang. Definieren Sie sie jedoch getrennt pro Metrik und Dienst. Eine hohe CPU-Auslastung kann bei einer Batch-Verarbeitung normal sein, während eine moderate Latenz im ERP sofortige Auswirkungen auf Mitarbeitende hat.
Ein Alarm sollte drei Informationen enthalten: Was ist passiert, warum ist es relevant, und wer muss als Nächstes handeln? Verknüpfen Sie ihn mit einem Dashboard, einem Runbook und einer klaren Eskalationsregel.
| Symptom im Betrieb | Auslösende Metrik | Vorgeschlagener Trigger | Empfohlene Priorität |
|---|---|---|---|
| Geschäftsanwendung reagiert nicht | Dienststatus und Antwortzeit | Dienst nicht erreichbar oder Antwort deutlich ausserhalb der normalen Baseline | P1 |
| Standort arbeitet nur verzögert | Latenz, Paketverlust, Bandbreite | Wiederholte Abweichung auf einer kritischen Verbindung | P1 |
| Anmeldungen schlagen gehäuft fehl | Authentifizierungsfehler | Auffällige Häufung gegenüber dem üblichen Muster | P2 |
| Speicherkapazität wird knapp | Freier Speicherplatz | Warnung vor Erreichen des individuell definierten Grenzwerts | P2 |
| Einzelnes Gerät ist veraltet | Patch- oder Agentenstatus | Fehlender Status nach dem vorgesehenen Wartungsfenster | P3 |
Eskalation statt Alarmflut
P1 bedeutet drohenden Betriebs- oder Verdienstausfall. P2 betrifft einen wichtigen Dienst mit vorhandener Ausweichmöglichkeit. P3 verlangt planbare Bearbeitung, P4 bleibt ein Hinweis für Review oder Wartung. Diese Einstufung muss zum Betrieb passen, nicht zu einer Standardvorlage des Herstellers.
Vier Fehler tauchen in KMU besonders häufig auf:
- Alles alarmieren: Überwachen Sie nur Parameter, die eine konkrete Aktion auslösen.
- Keine Wartungsfenster: Bündeln Sie erwartbare Meldungen während Updates und Umbauten.
- Keine Eigentümer: Hinterlegen Sie pro Alarm einen Verantwortlichen und eine Vertretung.
- Keine Nachkontrolle: Prüfen Sie nach der Entstörung, ob der Dienst stabil läuft und der Alarm geschlossen wurde.
Der Managed-Service-Partner sollte nicht jede Meldung sofort weiterleiten. Er muss Ereignisse korrelieren, bekannte Wartungsfälle unterdrücken und nur handlungsrelevante Störungen eskalieren. Genau daran zeigt sich die Qualität des Betriebsmodells.
Tool-Typen und Auswahlkriterien für KMU
Die Demo entscheidet nicht über die Eignung eines Monitoring-Tools. Der Betriebsalltag tut es. Ein System kann im Präsentationsraum beeindruckend aussehen und trotzdem scheitern, wenn Standarddienste fehlen, Zuständigkeiten nicht abgebildet werden oder jede Erweiterung zusätzliche Pflege verlangt.
Drei Ansätze im Vergleich
Klassisches Infrastruktur-Monitoring mit Nagios, PRTG oder Icinga ist für viele KMU der pragmatischste Einstieg. Diese Lösungen prüfen Geräte, Dienste und Schwellwerte, bieten Dashboards und lassen sich mit Ticketing oder Benachrichtigungen verbinden. Der Nachteil liegt in der begrenzten Tiefe bei verteilten Anwendungen und komplexen Abhängigkeiten.
Observability-Plattformen mit Grafana- und Prometheus-Stacks führen Metriken, Logs und teilweise Traces zusammen. Das schafft starke Möglichkeiten für Ursachenanalyse und anwendungsnahe Sichten. Ohne eigenes Know-how für Datenmodelle, Dashboards, Alert-Regeln und laufende Pflege wird der Ansatz jedoch schnell überdimensioniert.
Reine Endpoint- oder Log-Tools lösen ein spezielles Problem. Sie eignen sich für Patch-Überwachung, Gerätezustände oder Sicherheitsereignisse, ersetzen aber kein vollständiges Infrastruktur-Monitoring. Für ein belastbares Bild müssen die Daten zusammengeführt werden.
| Tool-Typ | Stärke | Schwäche | Ab Unternehmensgrösse sinnvoll |
|---|---|---|---|
| Infrastruktur-Monitoring | Schneller Einstieg, klare Schwellwerte, gute Geräteabdeckung | Begrenzte Ursachenanalyse komplexer Anwendungen | Für kleine und mittlere Umgebungen |
| Observability | Korrelation von Metriken, Logs und Traces | Höherer Betriebs- und Schulungsaufwand | Für technisch komplexe Umgebungen mit passendem Know-how |
| Reine Tools | Fokussierte Überwachung von Endpunkten oder Logs | Kein vollständiger Infrastrukturkontext | Als Ergänzung in jeder Grösse |
Neun Kriterien für die Auswahl
Prüfen Sie Lizenzierung pro Sensor oder mit unbegrenzter Abdeckung. Klären Sie, ob Agenten nötig sind, ob agentenlose Verfahren für Netzwerkgeräte funktionieren und ob Cloud-only oder On-Prem zum Schutzbedarf passt. Ebenso wichtig sind NIS-2-taugliche Reports, Schnittstellen zum Ticketsystem, Update-Modell, Schulungsaufwand, Vertragsbindung und Exit-Strategie.
Bewerten Sie ausserdem das Onboarding. Gibt es Vorlagen für Microsoft 365, Hypervisoren, Firewalls, Backup-Systeme und zentrale Datenbanken? Können Sie eigene Abhängigkeiten abbilden? Lassen sich Wartungsfenster und Eskalationen ohne Herstellerprojekt pflegen?
Auch kaufmännische Prozesse gehören in die Auswahl. Wer Angebote, Freigaben und laufende Leistungen sauber dokumentieren muss, profitiert von einem strukturierten Craftivo für Angebotswesen. Das ist kein Monitoring-Tool, hilft aber dabei, Toolkosten, Dienstumfang und Verantwortlichkeiten nachvollziehbar zu halten.
Meine Empfehlung für typische KMU: Starten Sie mit klassischem Infrastruktur-Monitoring und zentralem Log-Management. Ergänzen Sie Observability erst, wenn konkrete Anwendungen, Cloud-Abhängigkeiten oder wiederkehrende Ursachenanalysen den zusätzlichen Aufwand rechtfertigen.
Monitoring im Spannungsfeld von NIS-2 und BSI
NIS-2 verlangt von betroffenen Einrichtungen wirksame Massnahmen für Schutz, Erkennung und Reaktion. Monitoring liefert dafür die technische Grundlage, ersetzt aber weder Risikomanagement noch Verantwortlichkeit. Wer nur ein Dashboard besitzt, kann im Audit nicht automatisch nachweisen, dass Vorfälle erkannt und bearbeitet werden.
Das BSI beschreibt eine fortlaufende Lagebeobachtung und stellt mit seinen Lageberichten und Lagebildern einen Referenzrahmen für Betreiber, Behörden und KRITIS-nahe Organisationen bereit. Für Unternehmen bedeutet das: Verfügbarkeit, Incident Detection und Reporting sollten so organisiert sein, dass Entscheidungen später nachvollziehbar bleiben.
Welche Nachweise im Betrieb entstehen müssen
Erfassen Sie mindestens Authentifizierungsereignisse, privilegierte Zugriffe, Konfigurationsänderungen, Firewall-Meldungen und kritische Applikationsfehler. Speichern Sie Protokolle zentral und schützen Sie sie vor nachträglicher Manipulation. Legen Sie ausserdem fest, wer einen Vorfall klassifiziert, wer informiert wird und welche Reaktionszeit gilt.
| Monitoring-Baustein | NIS-2-Bezug | BSI-Grundschutz-Baustein | Typischer Nachweis |
|---|---|---|---|
| Verfügbarkeitsüberwachung | Resilienz und Betriebssicherheit | Betrieb und Infrastruktur | Verfügbarkeitsreport, Alarmhistorie |
| Sicherheits- und Authentifizierungslogs | Erkennung und Behandlung von Vorfällen | Protokollierung und Auswertung | Ereignisübersicht, Auswertungsprotokoll |
| Überwachung privilegierter Zugriffe | Zugriffsschutz und Risikomanagement | Identitäts- und Berechtigungsmanagement | Admin-Aktivitäten, Freigaben |
| Firewall- und Netzwerkereignisse | Schutz der Kommunikationswege | Netzsicherheit | Firewall-Report, Eskalationsnachweis |
| Incident-Eskalation | Melde- und Reaktionsfähigkeit | Notfallmanagement und Betrieb | Ticketverlauf, Runbook, Abschlussbericht |
Ein Audit verlangt typischerweise nicht nur eine Momentaufnahme. Gefragt sind nachvollziehbare Reports zu Verfügbarkeit, Sicherheitsereignissen, offenen und geschlossenen Incidents, Kapazitätstrends und Reaktionsabläufen. Die Verbindung von NIS-2 und praktischer IT-Überwachung zeigt, warum technische Daten und organisatorische Prozesse zusammengehören.
Für die Registrierung nennt die vorliegende Einordnung bis zum 30. Juni 2026 insgesamt 17.729 Unternehmen im BSI-Portal, während das BSI rund 29.500 betroffene Einrichtungen erwartet. Diese Zahlen sind in der praxisnahen Betrachtung von IT-Monitoring und NIS-2 dokumentiert. Die operative Konsequenz ist klar: Registrierung ist nur der formale Anfang. Ein KMU braucht Messpunkte, Eskalationsregeln und belastbare Nachweise.
Monitoring als Teil von Managed Services
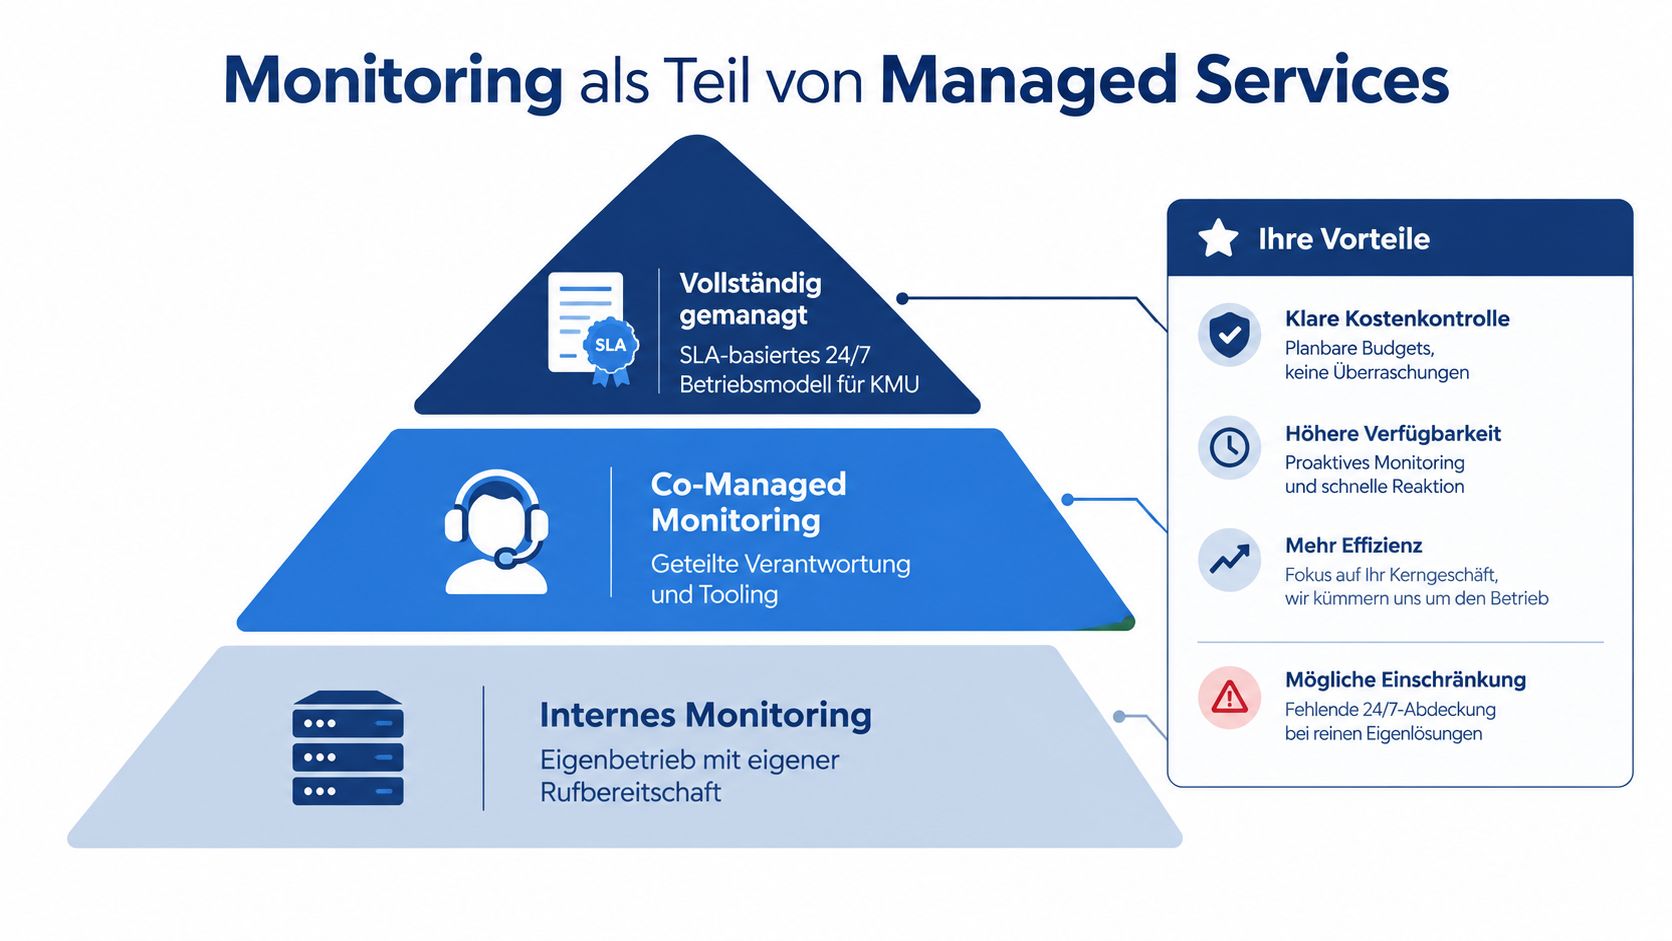
Ein KMU ohne eigene 24/7-Rufbereitschaft sollte nicht so tun, als könne es kritische Alarme jederzeit intern bearbeiten. Ein Managed-Service-Modell verlagert die Überwachung in einen SLA-basierten Betrieb und trennt Datensammlung, Alarmbewertung und Entstörung sauber voneinander.
Der Dienstleister übernimmt typischerweise die Pflege des Tool-Stacks, Schwellwerte, Alarmfilter, Eskalationen und Reports. Das Unternehmen behält Budgethoheit, Compliance-Verantwortung, Freigaben und die Entscheidung über sensible Daten. Diese Trennung verhindert, dass technische Zuständigkeit und unternehmerische Verantwortung verwechselt werden.
Was ausgelagert werden sollte
Sinnvoll auslagern lassen sich:
- Datensammlung: Agenten, SNMP-Abfragen, Cloud-Schnittstellen und Log-Weiterleitung.
- Alarmbewertung: Korrelation, Unterdrückung von Wartungsmeldungen und Priorisierung.
- Patch- und Zustandskontrolle: Erkennen fehlender Updates oder nicht erreichbarer Endpunkte.
- Wiederherstellungstests: Prüfen, ob Backups und dokumentierte Runbooks tatsächlich funktionieren.
- Reporting: Monatliche Berichte zu Verfügbarkeit, Incidents, Kapazität und offenen Risiken.
Im Unternehmen müssen Ansprechpartner, Eskalationspfade und Freigabegrenzen feststehen. Ein Dienstleister darf nicht bei jeder kleinen Warnung anrufen, aber er darf einen P1-Vorfall auch nicht in einem allgemeinen Ticketsystem verlieren.
Die Managed-Services-Leistungen von GSL Groß GmbH stehen beispielhaft für ein Modell, in dem Netzwerk, Server, Endpunkte und ausgewählte Cloud-Dienste kontinuierlich überwacht werden. Bei technischen Dienstleistern mit Anlagenbezug zeigt sich derselbe Grundgedanke auch ausserhalb klassischer IT, etwa bei der Wartung für PV und Wärmepumpe: Regelmässige Zustandsprüfung und definierte Reaktion sind zuverlässiger als eine Reparatur erst nach dem Ausfall.
Ein monatlicher Service-Report ist kein dekoratives PDF. Er ist die gemeinsame Arbeitsgrundlage für Geschäftsführung, IT, Datenschutz, Versicherung und Audit.
Achten Sie im Vertrag auf die Trennung von First-Level-Alerting und Second-Level-Entstörung. Nur dann lassen sich Reaktionszeiten, Übergaben und Verantwortlichkeiten messen. Ein günstiger Dienst ohne klare Eskalationslogik ist kein Managed Service, sondern ausgelagerte Benachrichtigung.
Best Practices für Einführung und Betrieb
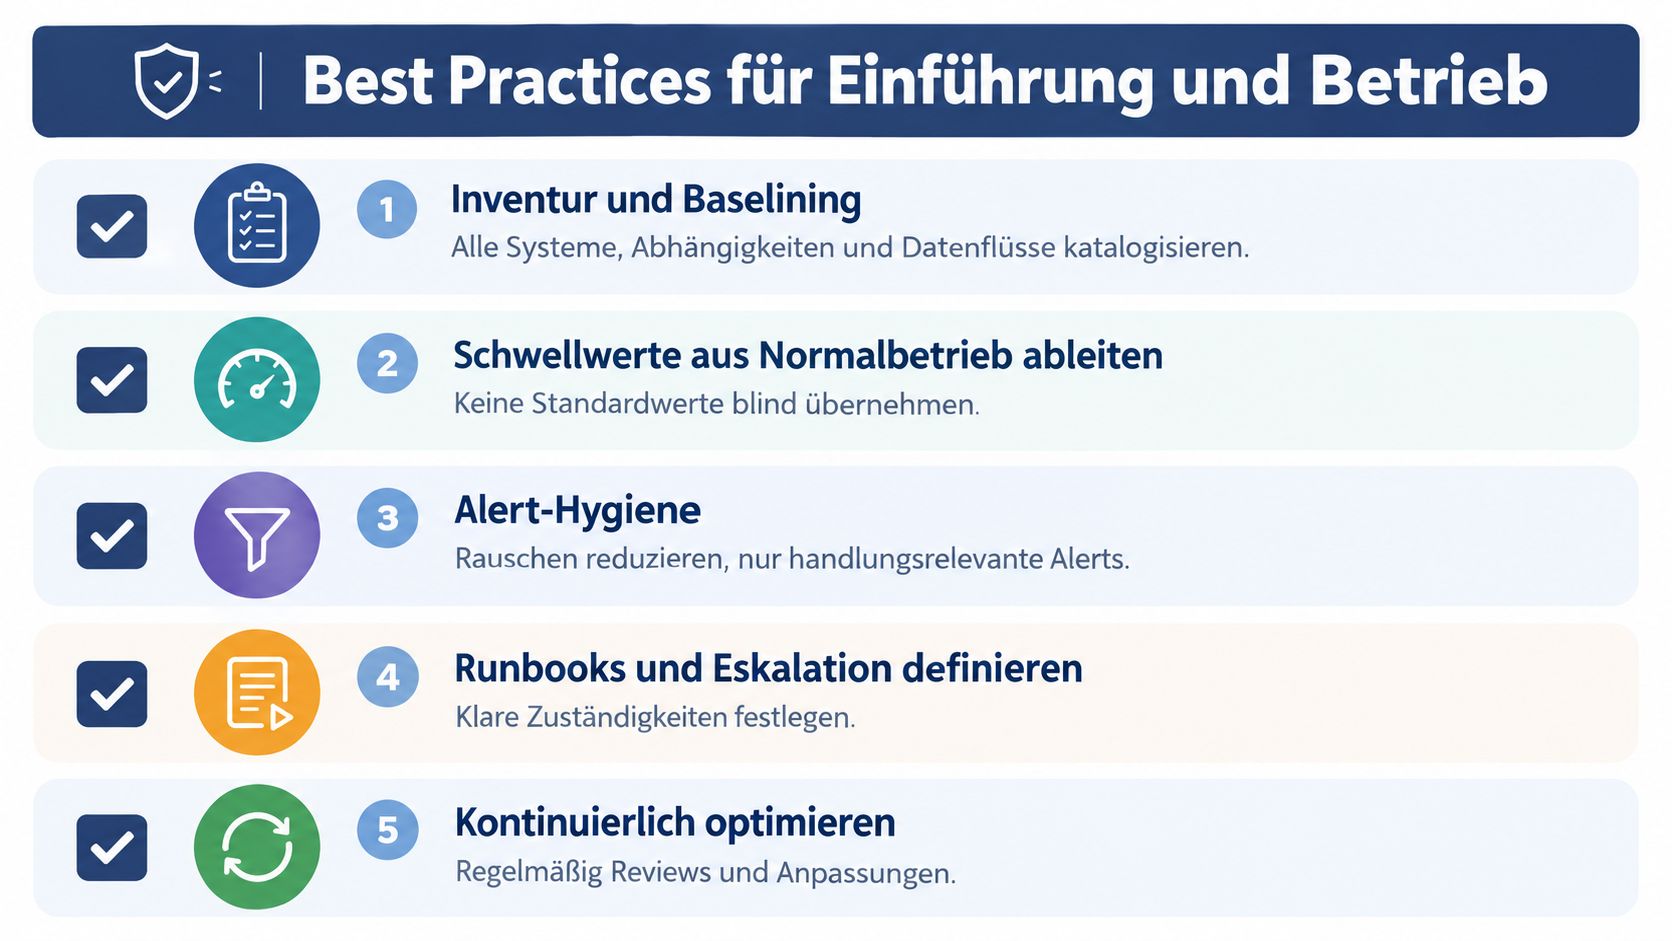
Die Einführung beginnt nicht mit einem Tool-Kauf. Sie beginnt mit einer Inventur. Erfassen Sie Systeme, Standorte, Abhängigkeiten, Datenflüsse und Geschäftsprozesse, die bei einem Ausfall zuerst betroffen wären.
Eine priorisierte Einführung
Reifegrad eins, Sichtbarkeit schaffen: Prüfen Sie Server- und Netzwerk-Erreichbarkeit mit einfachen Uptime-Checks. Hinterlegen Sie Eigentümer und Wartungsfenster. Ohne vollständige Asset-Liste bleibt jedes Dashboard unvollständig.
Reifegrad zwei, technische Tiefe ergänzen: Überwachen Sie CPU, RAM, Storage, Disk-I/O, Dienststatus und zentrale Logs. Definieren Sie die Schwellwerte aus dem normalen Betrieb Ihrer Umgebung, nicht aus einer beliebigen Herstellerempfehlung.
Reifegrad drei, Geschäftsprozesse testen: Ergänzen Sie Synthetic Transactions für zentrale Anwendungen, anwendungsnahe Performance-Metriken und automatisierte Runbooks. Ein Login- oder ERP-Test sagt mehr über die tatsächliche Nutzbarkeit aus als ein grünes Server-Symbol.
Reifegrad vier, Betrieb stabilisieren: Führen Sie wöchentliche Alert-Reviews durch, entfernen Sie Rauschen und testen Sie Eskalationsketten regelmässig. Quartalsweise Notfallübungen zeigen, ob Dokumentation, Wiederherstellung und Kommunikation zusammenpassen.
Die Dokumentation entscheidet
Halten Sie Runbooks, Asset-CMDB, Alarmpfade und Freigabeprozesse aktuell. Jeder kritische Alarm braucht eine Handlungsanweisung, eine verantwortliche Rolle und einen definierten Abschluss. Sonst zählt das System zwar Meldungen, verbessert aber nicht den Betrieb.
Meine klare Empfehlung für KMU lautet: Starten Sie klein, aber nicht zufällig. Überwachen Sie zuerst die Dienste mit dem grössten Geschäftsschaden, bauen Sie Logs und Nachweise kontrolliert aus und übertragen Sie die 24/7-Bewertung an einen Managed-Service-Partner, wenn die interne Besetzung dafür fehlt.
GSL Groß GmbH unterstützt KMU in Rheinland-Pfalz und Hessen bei der Bestandsaufnahme, dem Aufbau von proaktivem IT-Infrastruktur-Monitoring, zentralem Log-Management und NIS-2-tauglicher Dokumentation. Besprechen Sie Ihre aktuelle Umgebung und die passenden Eskalationswege direkt mit GSL Groß GmbH, damit aus einzelnen Alarmen ein verlässlicher, planbarer IT-Betrieb wird.