
Um 22:17 Uhr fällt in einem mittelständischen Produktionsbetrieb die Auftragsdatenbank aus. Gleichzeitig meldet ein Kunde fehlgeschlagene API-Aufrufe. Der IT-Leiter öffnet das Security-Tool und findet dort keine verwertbare Spur: Syslog steht seit Wochen wegen einer vollen Festplatte still, IIS-Logs wurden nie aktiviert und die Firewall überschreibt ihre Ereignisse nach kurzer Zeit. Es gibt keinen verlässlichen Zeitstempel, keine vollständige Quelle und kein belastbares Täterprofil.
Solche Situationen entstehen nicht, weil ein Unternehmen zu wenig Daten erzeugt. Sie entstehen, weil niemand festgelegt hat, welche Ereignisse gesammelt, geschützt, ausgewertet und für einen definierten Zeitraum verfügbar gehalten werden müssen. Log Management ist deshalb keine reine Archivaufgabe. Es ist eine prüfbare Sicherheitsfunktion, die Vorfälle rekonstruierbar macht, Angriffswege sichtbar werden lässt und bei der Einordnung hilft, ob ein Ereignis eine technische Störung, ein Sicherheitsvorfall oder ein meldepflichtiges Geschehen ist.
Inhaltsverzeichnis
- Wenn Logs fehlen, wird jeder Vorfall zur Blindfahrt
- Vom BSI-Grundschutz über NIS2 zur Pflicht, Logdaten auszuwerten
- So fliesst ein Log vom Server bis zur Auswertung
- Aufbewahren, schützen, standardisieren
- Log Management Schritt für Schritt im Mittelstand einführen
- Diese Kennzahlen zeigen Ihrer Geschäftsführung den echten Nutzen
- Eigenbetrieb oder Managed Service mit GSL Groß GmbH
- Ihre nächsten Schritte für ein auditierbares Log Management
Wenn Logs fehlen, wird jeder Vorfall zur Blindfahrt
Ein Log ist zunächst ein aufgezeichnetes Ereignis. Dazu gehören mindestens eine Quelle, ein Zeitstempel, eine Beschreibung der Aktion und, je nach System, ein Schweregrad oder Ergebnis. Ein fehlgeschlagener Administrationszugriff, eine Änderung an einer Firewall-Regel, ein Prozessstart auf einem Server oder ein Anwendungsfehler sind einzelne Bausteine einer späteren Ereigniskette.
Monitoring verfolgt ein anderes Ziel. Monitoring zeigt, ob ein Dienst erreichbar ist, ein Speicher voll läuft oder eine Anwendung langsam reagiert. Log Management hält dagegen die Datenspur fest, die erklärt, was passiert ist, wann es passiert ist und welches System beteiligt war. Beide Disziplinen gehören zusammen, aber ein grünes Monitoring-Dashboard ersetzt keine revisionsfähige Protokollierung.
Praktische Regel: Ein Alarm ohne verwertbare Ereignisse zeigt ein Problem. Eine vollständige Ereigniskette zeigt, wie es entstanden ist.
In Produktionsbetrieben sehe ich häufig drei Brüche. Die Systeme schreiben zwar Logs, aber lokal auf einzelnen Servern. Die Firewall protokolliert, doch niemand prüft, ob die Weiterleitung noch funktioniert. Oder das SIEM ist technisch vorhanden, liefert aber so viele unpriorisierte Meldungen, dass die Nachtschicht echte Warnzeichen übersieht.
Für Kliniken und soziale Einrichtungen verschärft sich das Problem durch verteilte Standorte, sensible Daten und kleine IT-Teams. Wenn ein Benutzerkonto missbraucht wird, müssen sich Anmeldeereignisse, Rechteänderungen, Netzwerkverbindungen und Zugriffe auf Anwendungen zeitlich zusammenführen lassen. Ohne zentrale Ablage und synchronisierte Zeit ist die Untersuchung schnell auf Vermutungen angewiesen.
Gutes Log Management liefert dagegen drei konkrete Vorteile:
- Rekonstruktion: Die IT kann eine Ereigniskette nachvollziehen, statt einzelne Dateien manuell zu durchsuchen.
- Erkennung: Wiederkehrende oder ungewöhnliche Muster lassen sich als Use Case auswerten.
- Nachweis: Verantwortliche können dokumentieren, welche Quellen aktiv waren, wie Logs geschützt wurden und wie ein Vorfall bearbeitet wurde.
Wer heute strukturiert sammelt, ist morgen nicht auf Vermutungen angewiesen. Das gilt auch dann, wenn kein eigenes Security Operations Centre und keine grosse SIEM-Mannschaft vorhanden sind.
Vom BSI-Grundschutz über NIS2 zur Pflicht, Logdaten auszuwerten
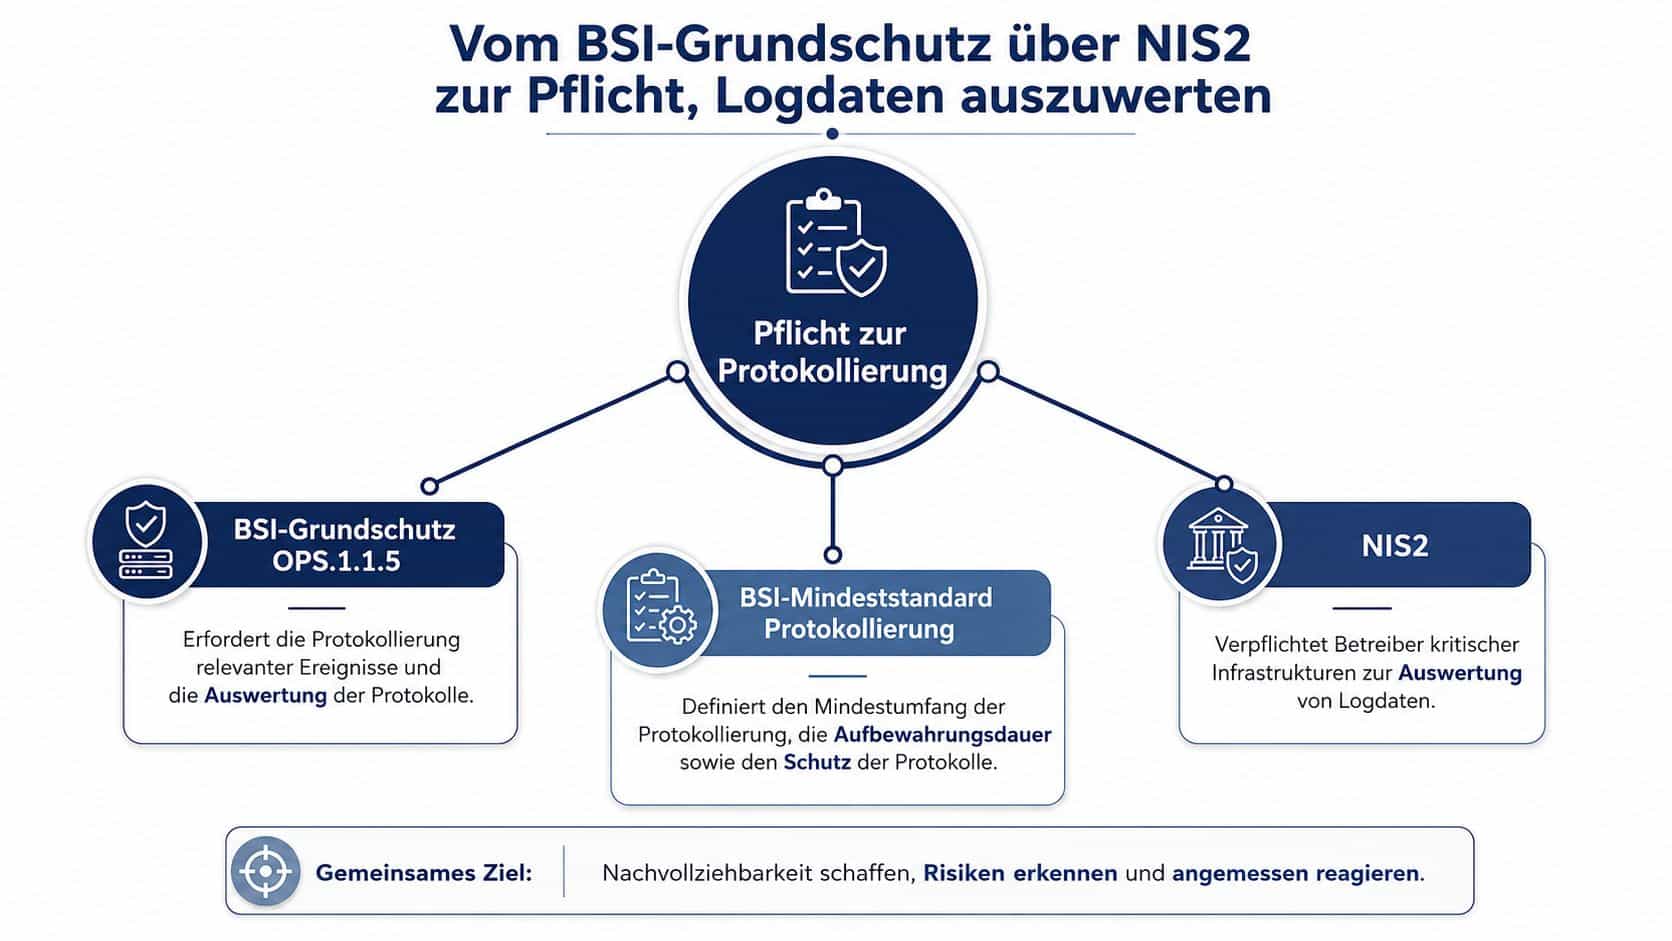
In Deutschland folgt Log Management einer klaren Regulierungskette. Der BSI-Grundschutz mit OPS.1.1.5 fordert für sicherheitskritische IT-Systeme eine Protokollierung administrativer Zugriffe und Konfigurationsänderungen. Dazu zählen Anmeldungen, Zugriffsversuche auf Rechteverwaltungskomponenten und Administrationsverbindungen. Auch Hardwareausfälle, Überlastsituationen und Anwendungsfehler müssen für die Analyse verfügbar bleiben.
Damit wird Log Management zu einer nachvollziehbaren Sicherheitsanforderung. Ein Konzept darf deshalb nicht bei Speicherorten und Aufbewahrungsfristen enden. Es muss festlegen, wer Ereignisse bewertet, welche Muster einen Alarm auslösen und wie die Integrität der Aufzeichnungen geschützt wird.
Der BSI-Mindeststandard verlangt einen aktiven Prozess
Der BSI-Mindeststandard zur Protokollierung und Detektion von Cyber-Angriffen beschreibt die automatische Speicherung von Ereignissen und ihre Bereitstellung für eine kontinuierliche Auswertung. Nicht erlaubte Verbindungsversuche müssen eine festgelegte Alarmmeldung auslösen.
Ein zentraler Log-Sink reicht daher nicht. Regeln, Dashboards und Zuständigkeiten machen aus gespeicherten Ereignissen einen nutzbaren Sicherheitsprozess. Besonders Kliniken, öffentliche Verwaltungen und kritische Infrastrukturen müssen zeigen können, dass relevante Meldungen bewertet und bearbeitet werden. Kleine IT-Teams brauchen dafür klare Eskalationswege, nicht zwingend ein eigenes SOC oder SIEM.
NIS2 verbindet Protokollierung mit Risikomanagement
Für NIS2-relevante Organisationen müssen Protokollquellen assetbezogen definiert, dokumentiert, überprüft und nach Risiko ausgewählt werden. Dazu gehören Netzverkehr, Nutzer- und Rechteänderungen, System- und Anwendungszugriffe, Authentifizierungen, privilegierte Zugriffe, kritische Konfigurations- und Backup-Dateien sowie Meldungen von Firewalls und IDS- oder AV-Systemen. Der Überblick zur Überwachung und Protokollierung ordnet diese Anforderungen praktisch ein. Eine verständliche Einführung bietet auch der Beitrag zur NIS2-Richtlinie und ihren Anforderungen.
Das NIS2-Umsetzungsgesetz setzt enge Meldefristen. Bei erheblichen Vorfällen sind eine Frühmeldung innerhalb von 24 Stunden, eine weitere Meldung innerhalb von 72 Stunden und ein Abschlussbericht innerhalb eines Monats vorgesehen. Die Registrierung beim BSI war bis 6. März 2026 erforderlich. Die Vorgaben stehen im veröffentlichten Gesetzestext.
Für KMU lautet die praktische Prüfungsfrage: Kann die aktuelle Lösung einen Vorfall rechtzeitig erkennen, belastbar belegen und fristgerecht melden? Datenschutz, Zugriffsschutz und branchenspezifische Vorgaben gehören in dieselbe Bewertung. Entscheidend ist ein dokumentierter Ablauf mit Verantwortlichen, auch wenn die Auswertung über einen Dienstleister stattfindet.
So fliesst ein Log vom Server bis zur Auswertung
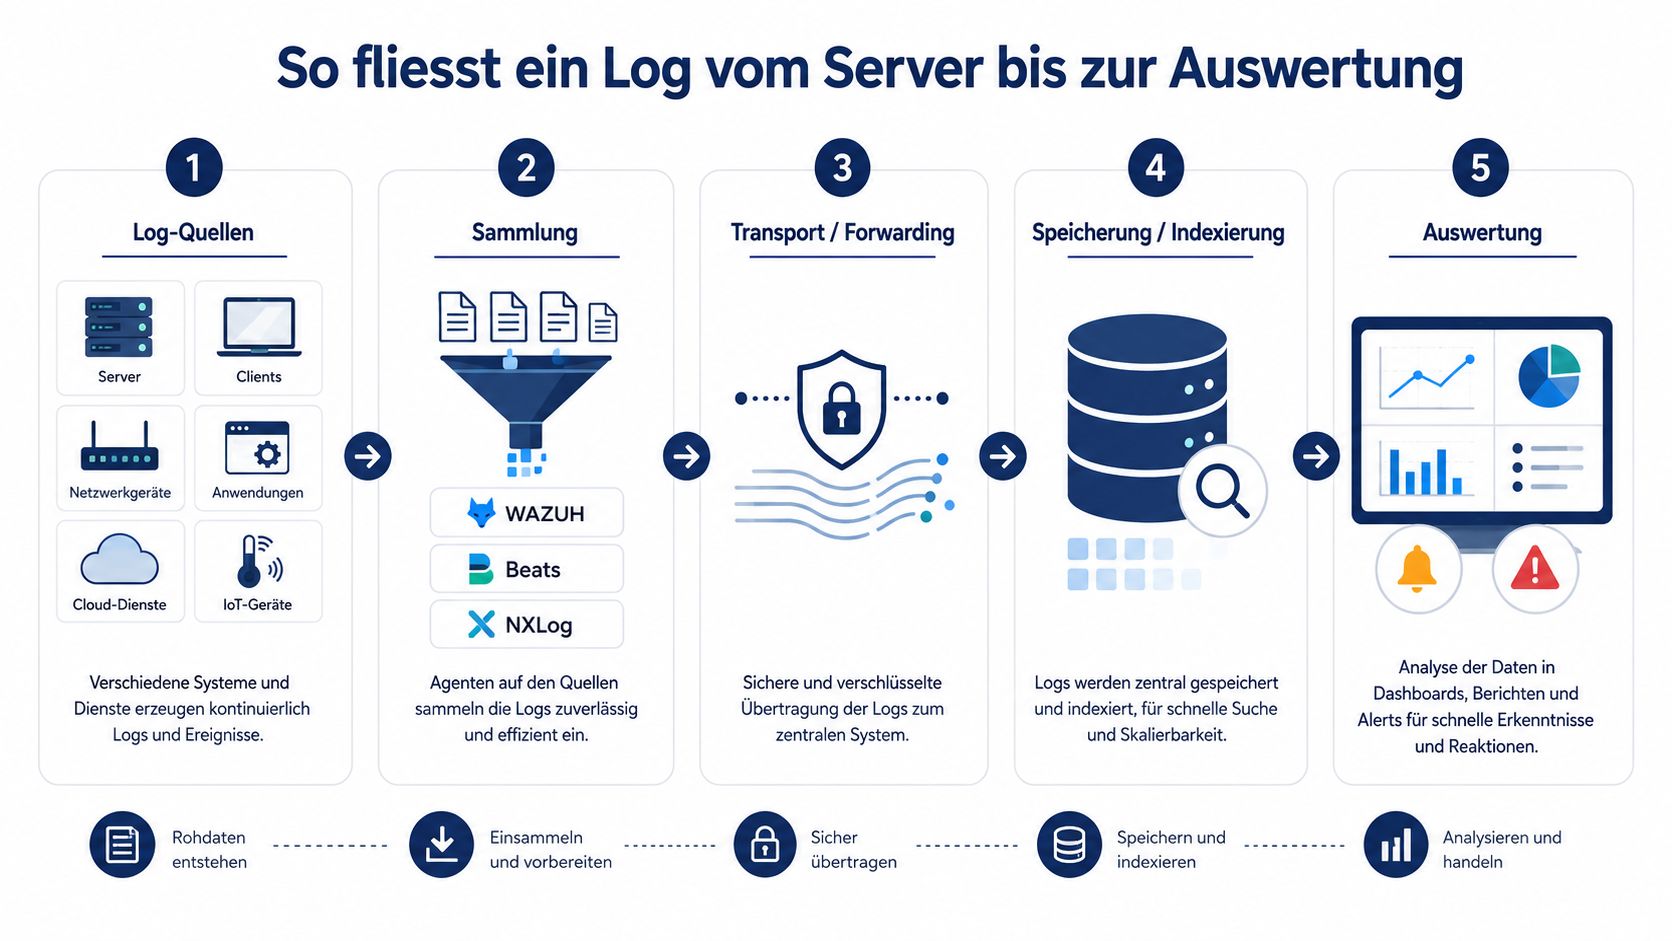
Ein funktionierendes Log Management besteht aus einer Kette. Fällt eine Stufe aus, kann die gesamte Untersuchung unvollständig werden. In kleinen IT-Teams sollte deshalb nicht zuerst die Plattform ausgewählt werden. Zuerst braucht es eine belastbare Architekturentscheidung.
Fünf Stufen, fünf Aufgaben
Erstens, die Quellen. Dazu gehören Windows- und Linux-Server, Clients, Netzwerkgeräte, Firewalls, Anwendungen, Cloud-Dienste und IoT-Systeme. Ein Quellenkatalog sollte für jedes Asset festhalten, welche Ereignisse entstehen, wem das System gehört und welchen Schutzbedarf es hat.
Zweitens, die Sammlung. Agenten wie Wazuh, Beats oder NXLog eignen sich für Systeme, auf denen lokale Erfassung und Vorverarbeitung erforderlich sind. Agentenloses Syslog, SNMP oder API-Connectoren kann bei Netzwerkgeräten und Cloud-Diensten sinnvoller sein. Die Wahl hängt davon ab, ob eine Quelle zuverlässig weiterleitet, lokal puffern kann und strukturierte Felder liefert.
Drittens, der Transport. Logs müssen über abgesicherte Kanäle übertragen werden. Bei instabilen Leitungen oder Standortverbindungen braucht es Puffer, damit Ereignisse während einer Unterbrechung nicht sofort verloren gehen. Die IT sollte ausserdem überwachen, ob Quellen tatsächlich senden, statt die Weiterleitung nur einmal zu konfigurieren.
Viertens, Speicherung und Indexierung. Häufig benötigte Daten gehören in einen schnell durchsuchbaren Bereich. Ältere Daten können kosteneffizienter archiviert werden, müssen aber weiterhin geschützt und auffindbar bleiben. Parser und Normalisierungsregeln für CEF, LEEF, OCSF oder Syslog sorgen dafür, dass Felder wie Benutzer, Quelle, Ziel und Schweregrad vergleichbar werden.
Fünftens, die Auswertung. Dashboards, Suchabfragen, Korrelationen und Alarme übersetzen Rohdaten in Handlung. Ein Use Case für privilegierte Anmeldungen ist für ein kleines Team meist wertvoller als eine unpriorisierte Sammlung sämtlicher Debug-Meldungen.
Ein passender SIEM-Ansatz für den Mittelstand sollte diese Kette abbilden, ohne die IT mit unnötiger Komplexität zu belasten.
Auditierbar wird die Architektur erst, wenn jede Stufe einen Verantwortlichen, eine erwartete Verfügbarkeit, eine Eskalation und eine Löschfrist besitzt. Ein Agent ohne Health-Check ist keine verlässliche Quelle. Ein zentraler Speicher ohne Zugriffskontrolle ist kein belastbarer Nachweis. Und ein Alarm ohne Runbook bleibt eine Meldung im Postfach.
Aufbewahren, schützen, standardisieren
Die richtige Aufbewahrung hängt vom Zweck des Logs ab. Buchhaltungsnahe Daten können unter den handelsrechtlichen Vorgaben bis zu 10 Jahre relevant sein, steuerbezogene Unterlagen unter der Abgabenordnung bis zu 8 Jahre. Für sicherheitsrelevante Logs gibt es dagegen nicht automatisch eine einheitliche Frist für jedes Unternehmen. Entscheidend sind Schutzbedarf, Risikobewertung, BSI-Anforderungen, NIS2-Bezug, Branchenregeln und die Frage, wie lange eine Untersuchung realistisch unterstützt werden muss.
Datenschutz darf dabei nicht nachträglich auf die Pipeline gesetzt werden. Personenbezogene Felder sollten auf Zweck und Erforderlichkeit geprüft, Zugriffe rollenbasiert begrenzt und Löschregeln dokumentiert werden. Eine zentrale Sammlung erhöht die Übersicht, vergrössert aber auch die Verantwortung für Berechtigungen, Verschlüsselung und Nachweisführung.
| Rechtsgrund / Anforderung | Typische Frist | Schutzmassnahme | Empfohlener Standard |
|---|---|---|---|
| Handelsrechtliche Aufbewahrung bei buchhaltungsnahen Daten | 10 Jahre | Zugriffsbeschränkung, Integritätsnachweis, Löschkonzept | Strukturierte Archivierung |
| Steuerrechtliche Aufbewahrung | 8 Jahre | Manipulationsschutz, dokumentierte Verantwortlichkeit | Revisionssichere Ablage |
| Sicherheits- und Betriebslogs | Risikobasiert festlegen | Verschlüsselung, zentrale Ablage, rollenbasierter Zugriff | Syslog, CEF, LEEF oder OCSF |
| NIS2-relevante Ereignisse | Nach Risikobewertung und festgelegtem Zeitraum | Sicher, manipulationsgeschützt und zugriffsbeschränkt | Normalisierte, auswertbare Ereignisse |
Syslog nach RFC 5424, CEF, LEEF und OCSF helfen, Quellen über Toolgrenzen hinweg vergleichbar zu machen. Standards lösen allerdings keine fehlenden Inhalte. Ein sauber formatiertes Log bleibt wertlos, wenn der Benutzer, die Aktion oder der Zeitpunkt nicht eindeutig erfasst werden.
Bei der Speicherung sollte die IT zwischen schneller Analyse und langfristiger Nachweisführung unterscheiden. Nicht jedes Ereignis muss dauerhaft in einem teuren Volltextindex liegen. Kritische Sicherheitsereignisse brauchen schnelle Suche und unveränderte Aufbewahrung, während weniger dringende Betriebsdaten in eine günstigere Archivschicht verschoben werden können. Vor der Einführung müssen ausserdem Löschfristen, Schlüsselverwaltung und der Umgang mit personenbezogenen Informationen schriftlich feststehen.
Log Management Schritt für Schritt im Mittelstand einführen
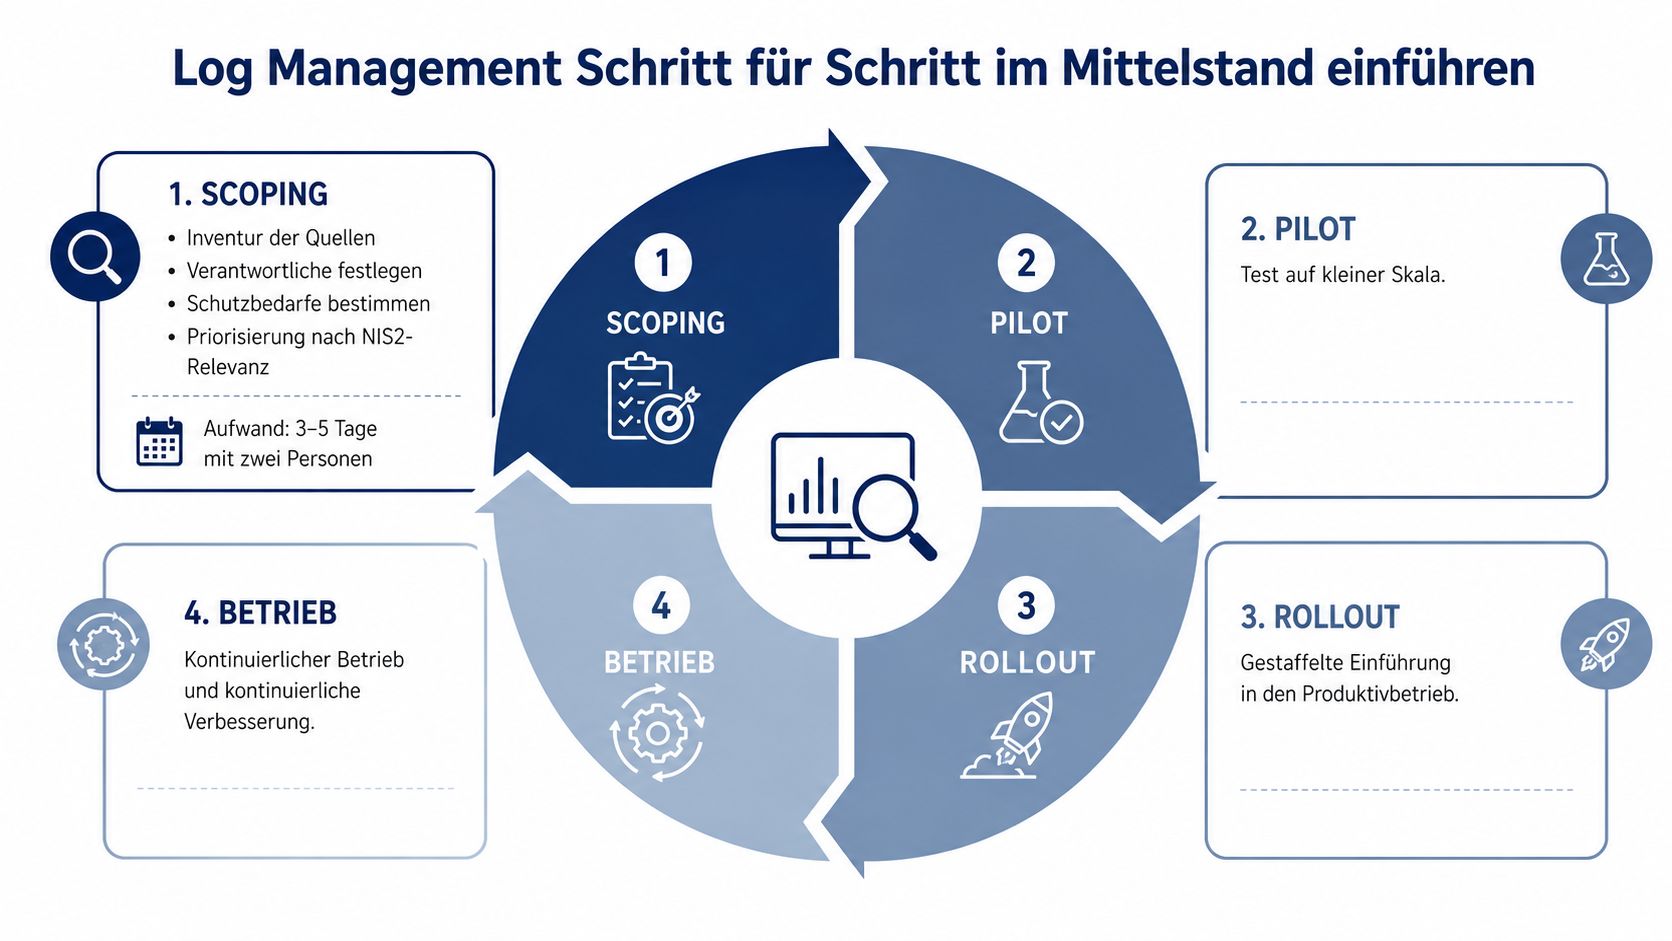
Ein mittelständisches Unternehmen braucht keinen Big-Bang-Rollout. Bewährt hat sich ein Vorgehen in vier Phasen, das technische Umsetzung und organisatorische Zuständigkeit gleichzeitig entwickelt.
Scoping schafft den belastbaren Anfang
Zuerst werden kritische Systeme, Logquellen, Eigentümer und Schutzbedarf erfasst. Die Priorisierung sollte sich an Geschäftsfolgen und NIS2-Relevanz orientieren, nicht daran, welche Quelle am einfachsten anzuschliessen ist. Für ein kleines Projektteam lässt sich diese Bestandsaufnahme mit zwei Personen in etwa drei bis fünf Tagen durchführen, sofern die Systemlandschaft ausreichend dokumentiert ist.
Das Ergebnis ist kein allgemeiner Wunschzettel, sondern eine Quellenliste mit konkreten Fragen:
- Quelle: Welche Ereignisse erzeugt das System?
- Verantwortung: Wer prüft Inhalt und Verfügbarkeit?
- Schutzbedarf: Welche Folgen hätte Manipulation oder Verlust?
- Auswertung: Welcher Alarm oder welcher Suchfall ist relevant?
- Aufbewahrung: Wann darf die Organisation die Daten löschen?
Der Pilot muss einen echten Vorfall abbilden
Im Pilot werden wenige, besonders aussagekräftige Systeme verbunden, etwa Active Directory, Firewall, ERP, Backup und Mailgateway. Statt möglichst viele Quellen anzuschliessen, definiert das Team konkrete Use Cases: privilegierte Anmeldung, Rechteänderung, verdächtige Authentifizierungsserie, Manipulation einer Backup-Konfiguration oder Ransomware-Indikatoren.
Ein Pilot über zwei bis vier Wochen gibt ausreichend Zeit, Parser, Alarmwege und Verantwortlichkeiten zu prüfen. Dabei wird nicht nur die technische Erkennung bewertet. Die IT sollte auch festhalten, welche Meldungen Fehlalarme erzeugen, wer sie bearbeitet und ob das zugehörige Runbook verständlich ist.
Rollout und Betrieb brauchen Disziplin
Beim Rollout kommen Quellen in Wellen hinzu. Fachbereiche werden informiert, das Ticketsystem wird angebunden und die Zuständigkeit pro Alarm wird schriftlich festgelegt. Im Betrieb gehören regelmässige Log-Health-Checks, Runbooks, Eskalationsketten und wiederkehrende Reviews zum Standard.
Typische Stolpersteine sind unsynchronisierte Zeitstempel, unklare Eigentümerschaft und eine überdimensionierte Erstauswertung. Wer jede Meldung gleich behandelt, erzeugt Alarmmüdigkeit. Wer keine Prüfung der Quellenverfügbarkeit einrichtet, bemerkt Ausfälle der Protokollierung möglicherweise erst beim Incident.
Diese Kennzahlen zeigen Ihrer Geschäftsführung den echten Nutzen
Die Geschäftsführung braucht kein Dashboard voller technischer Zähler. Events pro Sekunde, Indexgrösse und Datenvolumen können für den Betrieb wichtig sein, erklären aber allein nicht, ob das Unternehmen einen Vorfall beherrschen kann.
Ein monatliches Ein-Seiten-Dashboard sollte stattdessen zeigen, ob kritische Systeme abgedeckt sind, ob Meldungen ankommen und ob die Organisation handlungsfähig bleibt:
- Mean Time to Detect, MTTD: Wie schnell erkennt das Team ein relevantes Ereignis?
- Mean Time to Respond, MTTR: Wie schnell beginnt die Bearbeitung, Eindämmung und Dokumentation?
- Coverage-Rate: Welcher Anteil der kritischen Systeme liefert tatsächlich verwertbare Logs?
- Log-Lückenquote: Wie häufig fehlen Ereignisse wegen ausgefallener Agenten, Leitungen oder Speicherkomponenten?
- Audit-Readiness-Quote: Wie viele Prüfungsfragen lassen sich ohne nachträgliche Rekonstruktion beantworten?
- NIS2-Reportagezeit: Wie schnell kann das Unternehmen die Informationen für Frühmeldung, weitere Meldung und Abschlussbericht zusammenstellen?
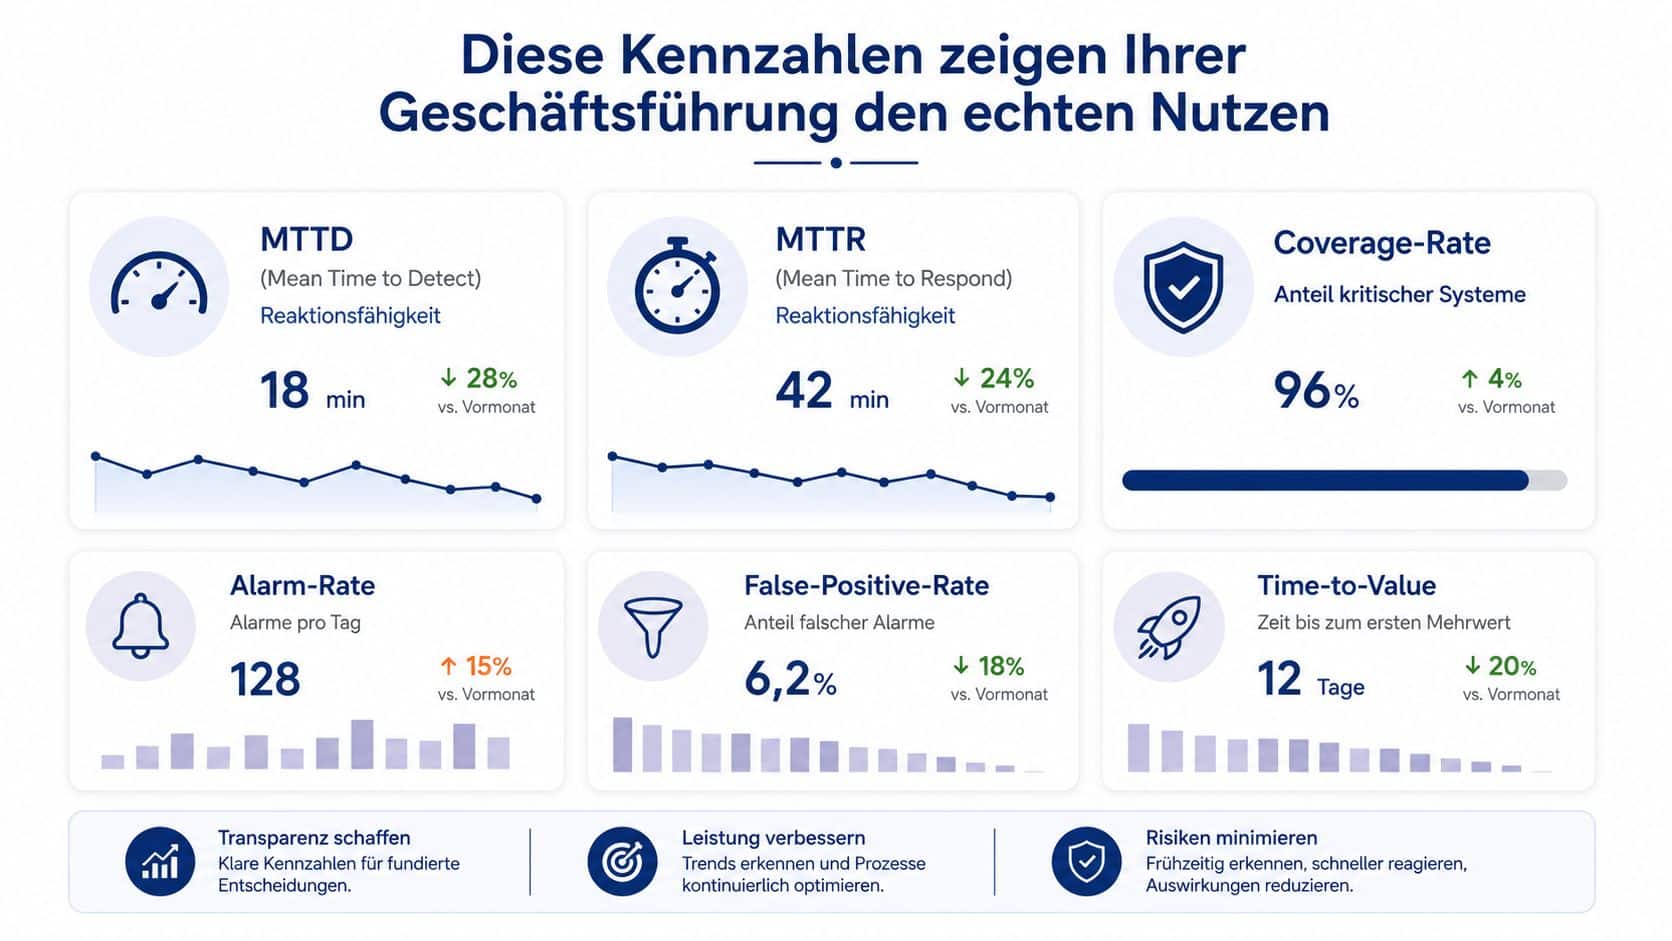
Wichtig ist die Verbindung zwischen Kennzahl und Entscheidung. Eine sinkende Coverage-Rate braucht einen technischen Eigentümer. Eine hohe Fehlalarmquote verlangt eine Überarbeitung der Regeln. Eine lange Reportagezeit zeigt, dass Logdaten zwar vorhanden sind, aber nicht in einem belastbaren Ablauf zusammengeführt werden.
Für die Geschäftsführung zählt nicht, wie viele Logs gespeichert werden. Entscheidend ist, ob die Organisation daraus rechtzeitig eine begründete Entscheidung ableiten kann.
Kostenkennzahlen bleiben sinnvoll, sollten aber mit dem Nutzen verbunden werden. Speicher- und Lizenzaufwand lassen sich etwa den abgedeckten kritischen Assets, der Suchgeschwindigkeit und der Auditierbarkeit gegenüberstellen. So wird Log Management als steuerbare Sicherheitsleistung sichtbar und nicht als unverständlicher Technikposten.
Eigenbetrieb oder Managed Service mit GSL Groß GmbH
Ein Eigenbetrieb gibt dem Unternehmen direkte Kontrolle. Dafür müssen Toolbetrieb, Storage, Parser, Regelpflege, Berechtigungen, Updates und Incident-Bereitschaft intern abgedeckt werden. Produkte wie Splunk, Graylog oder Wazuh unterscheiden sich deutlich bei Lizenzmodell, Betriebsaufwand und benötigter Erfahrung. Entscheidend ist nicht nur die Anschaffung, sondern wer an Wochenenden und bei Ausfällen reagiert.
Ein Managed Service verlagert bestimmte Betriebsaufgaben nach aussen. Das kann besonders dann sinnvoll sein, wenn kein eigenes 24/7-Personal vorhanden ist, eine Klinik oder ein Versorger belastbare Nachweise verlangt oder die Umgebung von On-Premises in eine hybride Architektur wächst. Für die NIS2-Fristen braucht der Dienstleister eine klar definierte Reaktionskette, während das Unternehmen seine Meldeverantwortung und Entscheidungen nicht vollständig abgeben kann.
| Kriterium | Inhouse | Managed Service mit GSL Groß GmbH | Trigger für Service |
|---|---|---|---|
| Tool und Lizenzen | Unternehmen wählt und finanziert Plattform selbst | Auswahl, Betrieb und Abstimmung werden als Service organisiert | Fehlende Erfahrung mit SIEM, Parsern oder Regelpflege |
| Storage und Betrieb | Eigene Kapazitätsplanung, Sicherung und Härtung | Betrieb mit definierten Zuständigkeiten und Reports | Hybride Umgebung oder verteilte Standorte |
| Personal | Interne Bereitschaft und Eskalation erforderlich | Vereinbarte Reaktionskette mit externem Betrieb | Kein eigenes 24/7-Team |
| NIS2-Prozess | Meldewege müssen intern aufgebaut und geübt werden | Logdaten, Triage und Nachweise können in den Prozess eingebunden werden | Hoher Zeitdruck bei Früh- und Folgemeldungen |
| Auditierbarkeit | Dokumentation und Evidenz liegen vollständig beim Unternehmen | Berichte und Betriebsnachweise werden gemeinsam geführt | Auditdruck durch Kliniken, Versorger oder Auftraggeber |
| Souveränität | Geeignet für isolierte Netze und besondere interne Vorgaben | Geeignet, wenn Betriebskompetenz kurzfristig fehlt | Wechsel von isolierter zu hybrider IT |
GSL Groß GmbH kann dabei als regionaler IT-Partner Log Management in Beratung, Betrieb und laufende Betreuung einordnen. Das ersetzt keine individuelle Prüfung. Vor der Entscheidung müssen Datenzugriff, Rollen, Aufbewahrung, Eskalation, Ausnahmen für isolierte Netze und die genaue Abgrenzung zwischen Dienstleister und Betreiber im Vertrag stehen.
Inhouse bleibt sinnvoll, wenn regulatorische Souveränität, abgeschottete Netze oder besondere Geheimhaltungsanforderungen im Vordergrund stehen und das nötige Personal vorhanden ist. Der Service ist meist die bessere Option, wenn die Organisation zwar Verantwortung behalten, aber Plattformbetrieb und kontinuierliche Überwachung nicht selbst leisten will.
Ihre nächsten Schritte für ein auditierbares Log Management
Eine umsetzbare Startliste sieht so aus:
- Kritische Systeme scopen: IT-Leitung und Fachverantwortliche erstellen binnen einer Woche den Quellenkatalog.
- Plattform auswählen: Sicherheits- und Betriebsverantwortliche prüfen zentrale Sammlung, NIS2-Auswertbarkeit, Rollenmodell und Archivierung.
- Aufbewahrung festlegen: Datenschutz, Compliance und IT dokumentieren Fristen, Löschung und Manipulationsschutz auf Basis der Risikobewertung.
- Alarmpfade definieren: Die IT benennt pro Use Case Empfänger, Eskalationsstufe, Reaktionszeit und Runbook.
- Log-Pipeline testen: Ein externer oder interner Sicherheitstest prüft Ausfall, Manipulation, Lücken und Wiederanlauf der Sammlung.
- Verantwortlichen ernennen: Eine Person hält Quellenliste, Regelwerk, Reviews und Auditnachweise aktuell.
Beginnen Sie nicht mit der Frage, welches SIEM am meisten Funktionen besitzt. Beginnen Sie mit der Frage, welche fünf bis zehn Ereignisse Ihr Unternehmen im ersten kritischen Zeitraum wirklich erkennen und belegen muss.
GSL Groß GmbH unterstützt mittelständische Unternehmen bei Scoping, zentraler Protokollierung, NIS2-Einordnung und dem laufenden Betrieb der Log-Pipeline. Vereinbaren Sie ein einstündiges Scoping-Gespräch über GSL Groß GmbH, um BSI-Anforderungen, Meldefristen und Ihre bestehende IT-Landschaft gemeinsam zu bewerten.