
Montagmorgen, der Fachbereich wartet auf das ERP, der Service Desk bekommt dieselben Rückfragen wie letzte Woche, und irgendwo in der Kette sagt jemand: „Wir haben den Fehler doch schon mal gesehen.“ Genau dort trennt sich Problem Management IT von bloßer Störungsbearbeitung. Wer wiederkehrende Ausfälle nur wegklickt, verwaltet Symptome. Wer die Ursache sauber verfolgt, gewinnt Ruhe im Betrieb, belastbare Nachweise für den NIS2-Kontext und am Ende wieder Zeit für die Dinge, die im Mittelstand wirklich Wert schaffen.
Inhaltsverzeichnis
- Warum Probleme in der IT kein Einzelschicksal sind
- Was Problem Management IT eigentlich bedeutet
- Abgrenzung zu Incident Management
- KPIs und Reporting
- Roadmap zur Einführung in 90 Tagen
- Tools und Integrationen
- Einbindung über einen regionalen MSP
- Abschluss-Checkliste
Warum Probleme in der IT kein Einzelschicksal sind
Ein einzelner Ausfall wirkt oft wie Pech. Zwei ähnliche Ausfälle in derselben Woche sind ein Muster. Drei gleiche Tickets aus einem Mandanten, einer Niederlassung oder einer Fachabteilung sind kein Zufall mehr, sondern ein Prozessproblem, das Ihre IT unnötig bindet.
Im deutschen KRITIS-Umfeld ist das kein theoretisches Thema. Das BSI meldete im Lagebericht 2024 490 Störungen bei KRITIS-Betreibern, im Lagebericht 2023 waren es 452 Meldungen. Zugleich verweist das BSI darauf, dass Störungen meldepflichtig werden, wenn sie zu einem Ausfall oder zu einer erheblichen Beeinträchtigung der Funktionsfähigkeit Kritischer Infrastrukturen führen oder führen können. BSI-Lagebilder zu Schadwirkungen und Störungen
Was das im Mittelstand praktisch heißt
Wenn morgens in Mainz das ERP hängt und nachmittags in Wetzlar dasselbe Fehlerbild wieder aufpoppt, dann brauchen Sie keine zweite Ad-hoc-Reaktion, sondern eine saubere Ursachenspur. Problem Management setzt genau dort an, wo Wiederholstörungen Produktivität, Vertrauen und Eskalationsaufwand fressen. Es reduziert nicht nur Tickets, sondern auch den nervigen Teil des Betriebs, den niemand in der Monatsplanung sieht.
Praktische Regel: Wenn ein Fehler mehr als einmal in ähnlicher Form auftaucht, gehört er nicht nur gelöst, sondern als Problem aufgenommen.
Für KMU ist das die beste Antwort auf knappe Kapazitäten. Sie entlasten den Service Desk, schaffen klare Verantwortlichkeiten und verhindern, dass dieselben Leute dieselben Symptome immer wieder manuell zusammensuchen. Gerade in Branchen mit hoher Verfügbarkeit, also Produktion, Gesundheit und Sozialwirtschaft, ist das kein Luxus. Es ist Betriebsstabilität.
Was Problem Management IT eigentlich bedeutet
Problem Management ist der Prozess, der hinter mehreren Incidents die gemeinsame Ursache sucht und dauerhaft beseitigt. Die Analogie aus dem Alltag passt gut. Eine gute Werkstatt ersetzt nicht nur dreimal hintereinander denselben billigen Schalter, sie prüft, warum die Serie auffällig ist. Ein guter Hausarzt klebt nicht nur Symptome, wenn der gleiche Infekt ständig zurückkommt, sondern schaut nach den Gründen.
Der Kern im ITIL-Alltag
Im ITIL-4-Rahmen gehört Problem Management zur Practice Problem Management. Dort geht es um Detektion, Analyse, Workaround-Management, bekannte Fehler und die Übergabe in Changes, damit die Ursache verschwindet. Das ist kein akademischer Feinschliff, sondern eine Arbeitsweise, die mittelständische Teams auch ohne Tool-Wildwuchs nutzen können.
Der Sinn ist einfach. Incidents werden schnell stabilisiert. Probleme werden systematisch ausgeräumt. Dazwischen liegt die Known-Error-Logik, also die saubere Dokumentation von Ursache, Workaround und späterer Behebung. Wer das diszipliniert pflegt, baut eine belastbare Wissensbasis auf, die bei knappen Ressourcen Gold wert ist.
Ein Problem ist erst dann sauber bearbeitet, wenn der Wiederholerkennungswert sinkt, nicht wenn das letzte Ticket geschlossen ist.
Das BSI hat den Handlungsdruck über die letzten Jahre sichtbar gemacht. Es berichtete für den Lagebericht 2023 von täglich rund 21.000 infizierten Systemen, die erkannt und an deutsche Provider gemeldet wurden, und im Lagebericht 2025 von durchschnittlich 119 neu bekannt werdenden Sicherheitslücken pro Tag, ein Plus von 24 Prozent gegenüber dem Vorjahr. BSI-Lagebericht 2024 als PDF
Die Schlussfolgerung ist klar. Die Zahl potenzieller Ursachen steigt, deshalb reicht reaktiver Support nicht mehr aus. Problem Management IT ist die methodische Antwort darauf.
Abgrenzung zu Incident Management
Viele Teams werfen Incident und Problem in einen Topf. Das rächt sich sofort, weil dann dieselben Leute gleichzeitig löschen und analysieren sollen. Für den Alltag brauchen Sie keine Theorie, sondern eine klare Arbeitsteilung.
| Kriterium | Incident Management | Problem Management |
|---|---|---|
| Auslöser | Nutzer meldet eine Störung | Trendmuster, Cluster oder wiederkehrende Incidents |
| Ziel | Schnelle Wiederherstellung | Dauerhafte Ursachenbeseitigung |
| Tempo | Stunden, SLA-getrieben | Tage bis Wochen, Root Cause im Fokus |
| Verantwortlichkeit | Service Desk, 1st und 2nd Level | Problem Manager, 3rd Level |
| Typischer Output | Gelöstes Ticket, Workaround | Known-Error-DB, RFC |
Das ist auch der Grund, warum Sie beides organisatorisch trennen sollten. Incident Management hält den Betrieb am Laufen. Problem Management verhindert, dass derselbe Betrieb morgen wieder gestört wird. Wenn Sie das vermischen, bekommen Sie zwar Aktivität, aber keine Entlastung.
Für den praktischen Ablauf ist eine saubere Verknüpfung mit dem Notfall- und Reaktionskonzept wichtig. Eine brauchbare Orientierung dazu liefert der interne Leitfaden zum Incident Response Plan. Nutzen Sie so ein Dokument als Klammer für Eskalation und Wiederanlauf, nicht als Ersatz für die Ursachenarbeit.
KPIs und Reporting
Wer Problem Management ernst nimmt, misst nicht nur geschlossene Tickets. Absolute Ticketzahlen sind irreführend, weil sie je nach Meldeverhalten, Toolreife und Teamkultur stark schwanken. Entscheidend ist, ob Wiederholungen abnehmen, Ursachen schneller sauber identifiziert werden und der Betrieb weniger an denselben Stellen stolpert.
Vier Kennzahlen, die im Mittelstand tragen
Aus der Logik von BSI, ISO-20000 und ITIL-4 braucht es vor allem vier belastbare Frühindikatoren.
| KPI | Zielwert | Datenquelle | Eskalation |
|---|---|---|---|
| Anteil wiederkehrender Incidents pro Quartal | unter 8 % | Ticketsystem, Kategorisierung, Problem-Records | Wenn der Anteil zwei Quartale in Folge steigt, Review im Management |
| Mean Time Between Known Errors | über 21 Tage | Problem-Register, Change-Historie | Wenn bekannte Fehler schneller zurückkehren, Root-Cause-Priorität erhöhen |
| Anteil Incidents mit bekannter Ursache beim Erstkontakt | über 60 % | Service-Desk-Wissen, Knowledge Base | Wenn der Wert sinkt, Wissenstransfer und Triage nachschärfen |
| RCA-Durchlaufzeit | unter 10 Arbeitstage | Problem-Tracking, RCA-Templates | Wenn Fristen reißen, Verantwortliche und Freigaben neu schneiden |
Die Zahlen sind als Zielbild zu verstehen, nicht als Dogma. Wichtig ist die Disziplin dahinter. Ein schlankes Dashboard reicht dafür völlig aus, solange es jede Woche auf dem Tisch der Geschäftsführung landet und nicht in einer Report-Mappe verstaubt.
Was in das Dashboard gehört
- Wiederholer pro Service: Nicht die Gesamtzahl zählt, sondern die Häufung je ERP, Mail, Datei- oder Produktionssystem.
- Offene Root-Cause-Fälle: Damit sichtbar wird, wo Probleme nur geparkt statt gelöst werden.
- Workaround-Abdeckung: Damit klar wird, ob der Service Desk handlungsfähig bleibt.
- Überfällige Maßnahmen: Damit aus Analyse auch wirklich eine Änderung entsteht.
Wenn Sie Reporting und Nachweisfähigkeit enger verzahnen wollen, lohnt ein Blick auf das interne Konzept für Compliance Reporting. Gerade im NIS2-Umfeld ist das nützlich, weil dokumentierte Vorfälle und Maßnahmen dann nicht nachträglich zusammengesucht werden müssen.
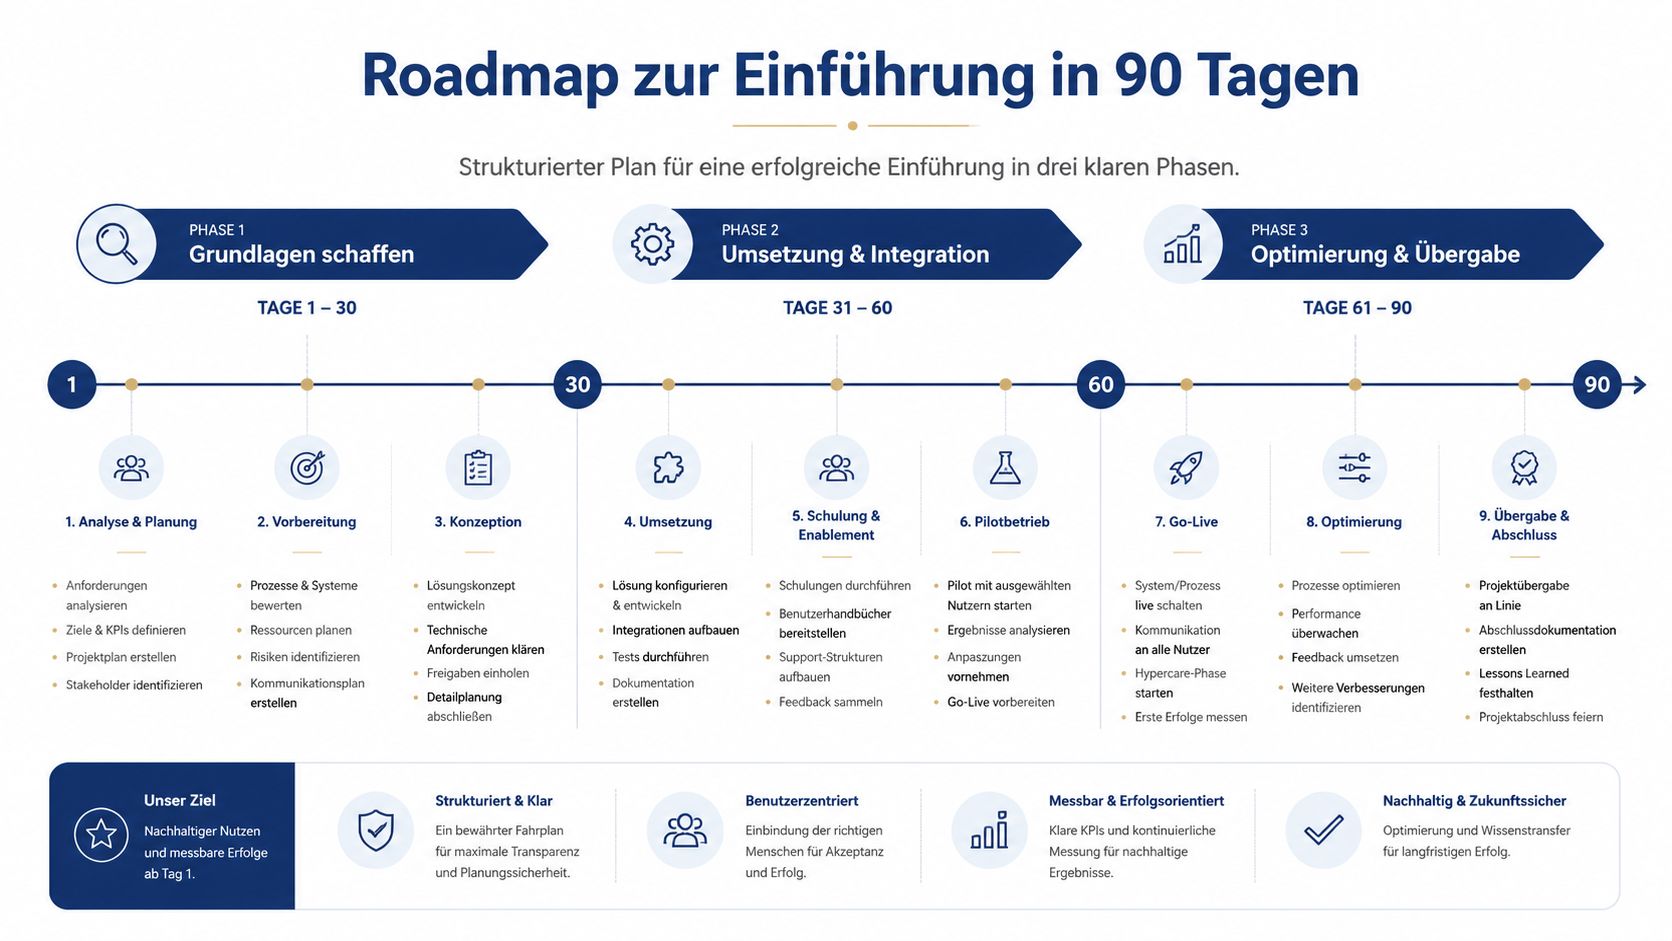
Roadmap zur Einführung in 90 Tagen
Ein gutes Problem-Management-Setup braucht keinen Großumbau. Es braucht einen klaren Sprint, eine Person mit Rückgrat und die Bereitschaft, erst den Prozess zu sauber zu bekommen und dann das Tooling zu veredeln.
Tage 1 bis 15, Fokus auf Auswahl und Zuschnitt
Starten Sie mit den Top-10-Incidents der letzten 90 Tage. Suchen Sie nicht den elegantesten Anwendungsfall, sondern den teuersten Wiederholer. ERP, E-Mail oder ein Standort mit vielen Tickets sind oft die beste Wahl, weil der Hebel sofort sichtbar wird.
Benennen Sie einen Problem Manager mit realistischem Zeitbudget. In vielen KMU reichen 6 bis 10 Stunden pro Woche, wenn die Schnittstellen klar sind und der Service Desk sauber vorqualifiziert. Klären Sie gleichzeitig, welche Incidents überhaupt problemwürdig sind, damit nicht jedes Ticket unnötig einen Analyseprozess startet.
Tage 16 bis 45, Fokus auf Analyse und Wissen
Jetzt braucht es ein einfaches RCA-Template und eine schlanke Known-Error-Datenbank. SharePoint, Confluence oder ein vergleichbares internes Wiki reichen völlig aus, solange Ursache, Workaround und Status dokumentiert werden. Schulen Sie das Team in zwei kurzen Blöcken von je 90 Minuten, damit alle dieselbe Sprache sprechen.
Wichtig ist, in dieser Phase nicht zu viel Tooling einzukaufen. Ein gutes Formular und eine klare Pflicht zur Dokumentation schlagen zehn halbfertige Integrationen. Wer hier aufräumt, spart später viel Reibung.
Tage 46 bis 75, Fokus auf Workflow und Eskalation
Jetzt wird Problem Management in den Ticket-Workflow eingebunden. Bauen Sie eine dreistufige Eskalationsmatrix, damit klar ist, wann der Service Desk, wann der Fachverantwortliche und wann die Geschäftsführung oder der externe Partner dran ist. Ab hier gehört ein wöchentliches Reporting dazu, sonst versandet die Disziplin.
Für viele Organisationen passt hier auch ein externer Praxisleitfaden wie die Relaunch-Strategie für Dienstleister und KMU als Denkmodell für saubere Phasen, klare Verantwortungen und einen festen Go-Live-Zeitpunkt. Der Punkt ist nicht Marketing, sondern Konsequenz im Vorgehen.
Tage 76 bis 90, Fokus auf Stabilisierung
Jetzt reviewen Sie Schwellenwerte, Nachweise und Verantwortlichkeiten. Was nicht genutzt wird, fliegt raus. Was im Alltag funktioniert, wird in den Linienbetrieb übergeben. Genau an dieser Stelle scheitern viele Projekte, weil parallel noch Change-Vorhaben, Tooltests oder andere Prioritäten laufen.
Tools und Integrationen
Tools helfen nur, wenn der Prozess sitzt. Wer ohne klare Rollen und Klassifizierung einkauft, macht aus teurer Software nur sauber verpacktes Chaos. Im Mittelstand zählt deshalb zuerst, was Sie schon haben, nicht die längste Funktionsliste.
Welche Werkzeugklassen sich wirklich lohnen
| Tool-Klasse | Beispiele | Nutzen | Stolperstein |
|---|---|---|---|
| Ticket-Tools | Jira Service Management, Zendesk, Freshservice, GLPI | Workflow-Builder, RCA-Vorlagen, Übergabe an Problems | Lizenzkosten pro Agent |
| Monitoring | Checkmk, PRTG, Grafana, Prometheus | Alarm-Eingang als Trigger für Problem-Tickets | Sensor-Flut ohne Filter |
| Wissensdatenbank | Confluence, Wiki.js, Notion | Known-Error-DB, Workarounds, Lernbasis | Pflege bleibt liegen |
| Integrationen | Webhook, Plugin, iFrame, Asset-Datenbank | Kontextfluss zwischen Meldung, Asset und Wissen | Brüche durch schlechte Datenqualität |
Die Reihenfolge ist entscheidend. Starten Sie mit der vorhandenen Ticket-Suite, binden Sie Monitoring an und führen Sie ein Wiki erst ein, wenn der Pilot läuft. Wer zuerst die Wissensdatenbank baut, ohne dass jemand sie pflegt, produziert nur mehr Leerlauf.
Was in der Praxis den Unterschied macht
Monitoring soll Probleme anstoßen, aber nicht jeden Alarm in Daueralarm verwandeln. Sie brauchen Filter, Priorisierung und eine saubere Zuordnung zu Services. Gerade bei knappen Teams und NIS2-Druck zählt jede Stunde, die nicht in Alarmrauschen verloren geht. Ein regionaler Partner wie GSL Groß GmbH lohnt sich, wenn Sie Betrieb, Monitoring und Support zusammenführen wollen. Dort bekommen KMU Managed Services, proaktives Monitoring und dokumentierte Betreuung als Basis für sauberes Problem Management.
Klarer Rat: Kaufen Sie kein Tool, bevor Sie Rollen, RCA-Pflicht und Ticket-Klassifizierung festgelegt haben.
Einbindung über einen regionalen MSP
Wenn intern Zeit fehlt, zählt ein klarer Partner mehr als ein weiteres Tool. Ein regionaler Managed-Service-Provider hilft vor allem dort, wo kleine IT-Teams sonst an Dokumentation, Ursachenanalyse und Nachweispflichten hängen bleiben. Die fachliche Priorität bleibt bei Ihnen, der Betrieb wird sauber mitgeführt.
Warum das gerade für KMU sinnvoll ist
Bei knappen Ressourcen sollte der MSP die wiederkehrenden Betriebsaufgaben übernehmen, während Ihr Haus die Entscheidungen zum Risiko, zu Changes und zur Freigabe trifft. So bleibt Problem Management IT kein Nebenkriegsschauplatz, sondern wird Teil der Betriebssteuerung.
Für NIS2 ist das ein echter Vorteil. Meldungen, Eskalationswege und Audit-Spuren landen direkt dort, wo sie im Ernstfall gebraucht werden, im Ticketsystem und in der Dokumentation. Wer diese Nachweise sauber führen will, braucht keine Heldentaten, sondern klare Verantwortlichkeiten und eine belastbare Zuordnung von Vorfall, Ursache und Maßnahme.
| Aspekt | Eigenleistung | Mit regionalem MSP |
|---|---|---|
| Reaktionsbereitschaft | Hängt an internen Kapazitäten | Klar geregelt und nachvollziehbar |
| Monitoring | Oft nebenbei betrieben | Dokumentiert und mit Zuständigkeiten verknüpft |
| Eskalation | Häufig personenabhängig | Mit fester Matrix und sauberer Übergabe |
| Nachweisfähigkeit | Verstreut über mehrere Kanäle | Zentral im System dokumentiert |
Für Betriebe, die diese Bereiche externalisieren möchten, bietet GSL Managed Services unter https://www.gsl-computer.de/managed-it-services-maximierte-it-sicherheit-und-it-effizienz-fuer-den-mittelstand/.
Die Zusammenarbeit sollte wie eine saubere Arbeitsteilung wirken, nicht wie blindes Outsourcing. Gerade für KMU ist das oft die vernünftigere Lösung als eine interne Spezialistenrolle aufzubauen, die sich personell auf Dauer nicht halten lässt.
Abschluss-Checkliste
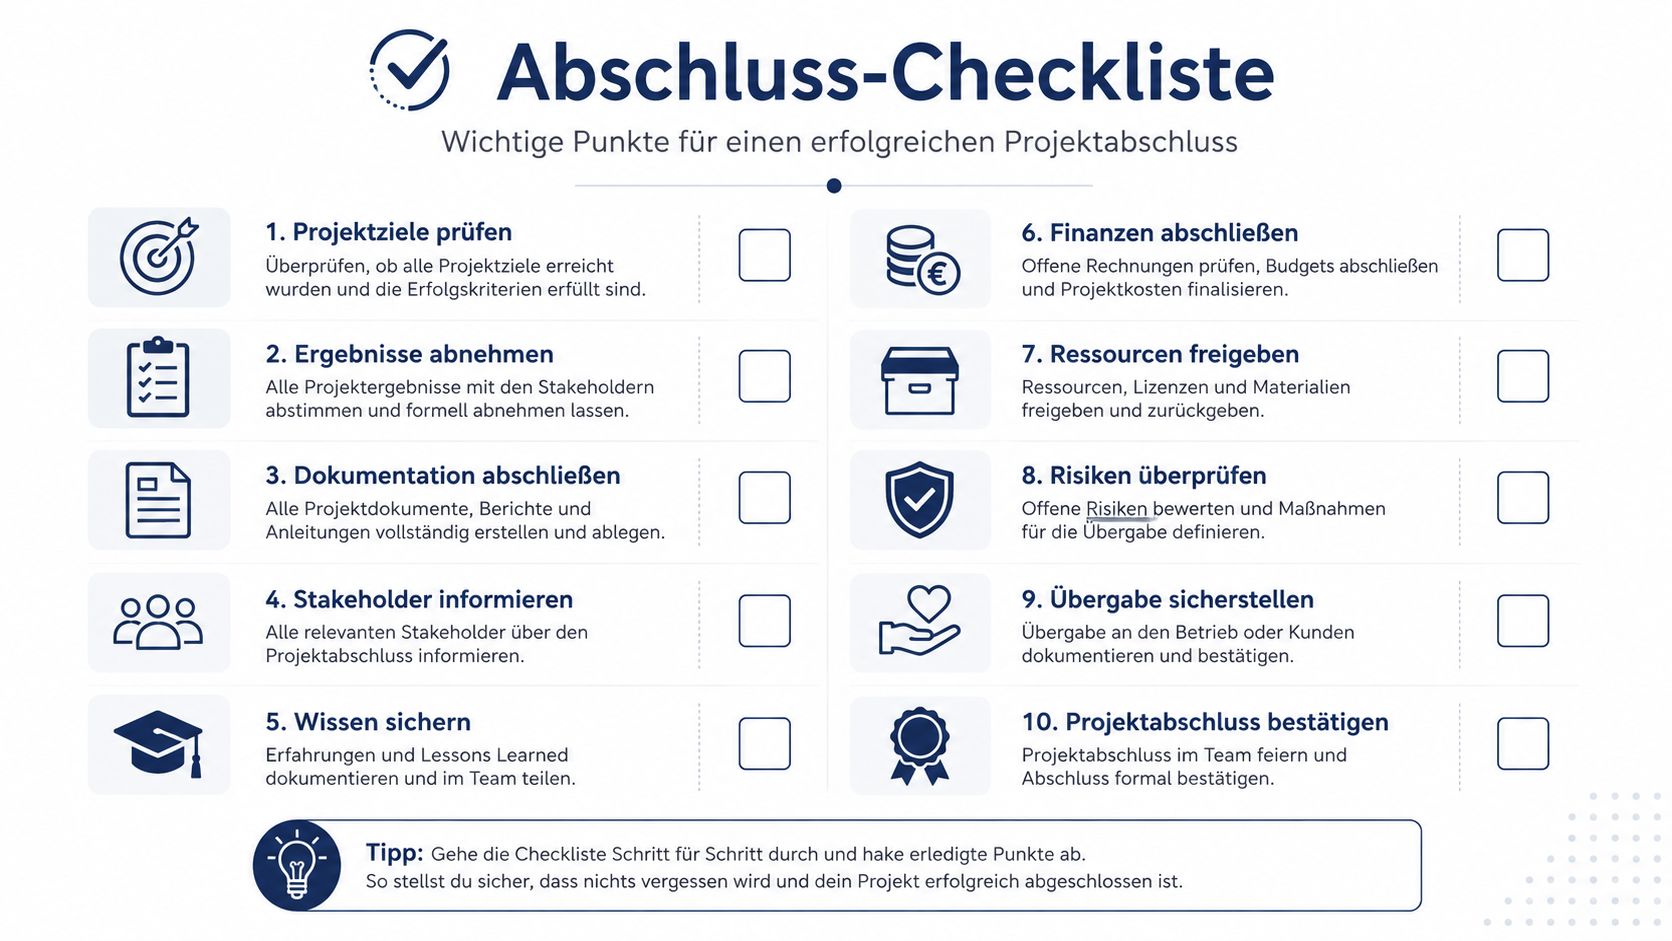
Wenn Sie Problem Management IT nicht als Papierübung, sondern als Betriebswerkzeug aufsetzen wollen, brauchen Sie drei Dinge. Einen klaren Besitzer, einen minimalen Prozess und einen festen Takt für Auswertung und Nachsteuerung. Alles andere ist Beiwerk.
Die nächsten 90 Tage in drei klaren Schritten
- Heute festlegen: Benennen Sie den Verantwortlichen für Problem Management, definieren Sie die Ticket-Kategorien und schreiben Sie die Schnittstelle zum Incident Management nieder.
- Binnen zehn Tagen erledigen: Legen Sie die ersten KPI-Schwellenwerte fest, damit das Team weiß, wann etwas nur beobachtet und wann es eskaliert wird.
- Vor Quartalsende terminieren: Setzen Sie das erste Review mit dem MSP oder dem internen Betriebsteam auf und entscheiden Sie dort über die nächsten Maßnahmen.
In den Wochen drei bis sechs gehören die ersten Root-Cause-Fälle und die monatliche Ursachenrunde dazu. Ab Woche sieben integrieren Sie Monitoring, Wissensbasis und Known-Error-Datenbank so, dass der Service Desk im Alltag wirklich davon profitiert.
Wenn Ihr Team dieselben Störungen zweimal sauber dokumentiert und beim dritten Mal noch immer überrascht ist, fehlt kein Tool, sondern Disziplin im Prozess.
Wenn Sie Problem Management IT in Ihrem Unternehmen pragmatisch aufsetzen wollen, unterstützt die GSL Groß GmbH mit Managed Services, proaktivem Monitoring und strukturierter IT-Betreuung für den Mittelstand. Für Betriebe in Rheinland-Pfalz, Hessen und dem Saarland ist das ein direkter Weg zu sauberer Eskalation, klarer Dokumentation und weniger Wiederholstörungen.