
Am Montagmorgen läuft das ERP langsam, der Drucker im Lager ist offline, und im Vertrieb fragt jemand, warum die Auftragsbestätigung schon wieder hängt. In vielen KMU beginnt der Tag genau so, mit gefühltem Chaos und der gleichen Frage: Was ist diesmal kaputt, und wer sieht es zuerst? Ohne saubere Überwachung bleibt IT dann ein Stille-Post-Spiel, in dem jeder etwas ahnt, aber niemand belastbar erklären kann, wo die Störung wirklich sitzt.
IT Monitoring Software ist in so einer Lage kein Komfortwerkzeug. Sie ist die Frühwarnanlage für Systeme, die im Alltag funktionieren müssen, ohne dass jemand ständig danebensteht. Gerade in Deutschland ist der Druck hoch, weil der BSI-Lagebericht 2023 im Berichtszeitraum durchschnittlich 68 neue Schwachstellen pro Tag ausweist, rund 24 Prozent mehr als im vorherigen Zeitraum. Das ist ein klarer Hinweis darauf, warum kontinuierliche Überwachung und schnelles Reagieren heute zum normalen Betrieb gehören, nicht nur zum Notfallplan. BSI-Lagebericht 2023
Wer IT nur dann anschaut, wenn schon etwas brennt, arbeitet im Rückspiegel. Wer früh misst, meldet und priorisiert, hält den Betrieb handlungsfähig. Für den Einstieg lohnt sich auch ein Blick auf die grundlegende Sicherheitsseite von Unternehmen, etwa bei IT-Sicherheit für Unternehmen, denn Monitoring ist immer Teil eines größeren Sicherheitsbilds.
Inhaltsverzeichnis
- Warum IT Monitoring für KMU heute unverzichtbar ist
- Was IT Monitoring Software wirklich leistet
- Welchen konkreten Nutzen Monitoring für KMU schafft
- Die wichtigsten Funktionen verständlich erklärt
- So wählen Sie die passende IT Monitoring Software aus
- Implementierung in fünf schlanken Phasen
- Managed Services als Alternative zum Eigenbetrieb
Warum IT Monitoring für KMU heute unverzichtbar ist
Ein typischer Montag im Mittelstand wirkt harmlos, bis die ersten Meldungen reinkommen. Das ERP braucht ewig, die Telefonanlage wirkt träge, und im Lager meldet jemand, dass ein Scanner „spinnt“. Solange niemand sieht, ob das Problem im Netz, am Server, in einer Anwendung oder beim Update liegt, läuft die Firma im Blindflug.
Der Unterschied zwischen Reaktion und Steuerung
Genau hier trennt sich Feuerwehrmodus von Steuerung. Ohne Monitoring wird aus einer kleinen Störung schnell ein Telefonmarathon mit Vermutungen, Rückfragen und Prioritätenwechseln. Mit Monitoring sieht die IT, was zuerst abweicht, welche Komponente betroffen ist und ob das Ereignis Teil eines größeren Musters ist.
Die deutsche Referenz für diese Denkweise ist der Verfügbarkeitsgedanke des BSI. Das Amt beschreibt Verfügbarkeit als die Eigenschaft von Diensten, Systemen, Anwendungen oder Netzen, von Anwendern wie vorgesehen genutzt werden zu können. Für Management und IT heißt das, nicht nur „läuft“ oder „läuft nicht“ zu fragen, sondern nach messbarer Nutzbarkeit im Alltag.
Praktische Regel: Wenn ein Systemausfall nur dann sichtbar wird, wenn Mitarbeitende ihn melden, ist es zu spät für sauberen Betrieb.
Für KMU ist das besonders heikel, weil Ausfälle selten isoliert bleiben. Ein langsamer Server zieht Arbeitsplätze, Drucker, Warenwirtschaft und Support mit nach unten. Monitoring macht aus diesem Bauchgefühl ein belastbares Bild, und genau das brauchen Geschäftsführung und IT-Leitung, um Entscheidungen nicht nach Lautstärke, sondern nach Wirkung zu treffen.
Warum Transparenz mehr wert ist als Hoffnung
Die eigentliche Stärke liegt nicht im Alarm selbst, sondern in der frühen Einordnung. Eine Warnung ohne Kontext ist nur Lärm. Eine Warnung mit Ursache, betroffener Anwendung und Zuständigkeit führt direkt in die nächste Handlung.
Darum ist Monitoring für KMU kein Luxusprojekt, sondern eine Voraussetzung für Verlässlichkeit. Wer Systeme nur verwaltet, sobald Beschwerden kommen, bleibt immer einen Schritt hinter dem Problem. Wer dagegen misst, vergleicht und dokumentiert, verschiebt den Betrieb von zufällig stabil zu bewusst gesteuert.
Was IT Monitoring Software wirklich leistet
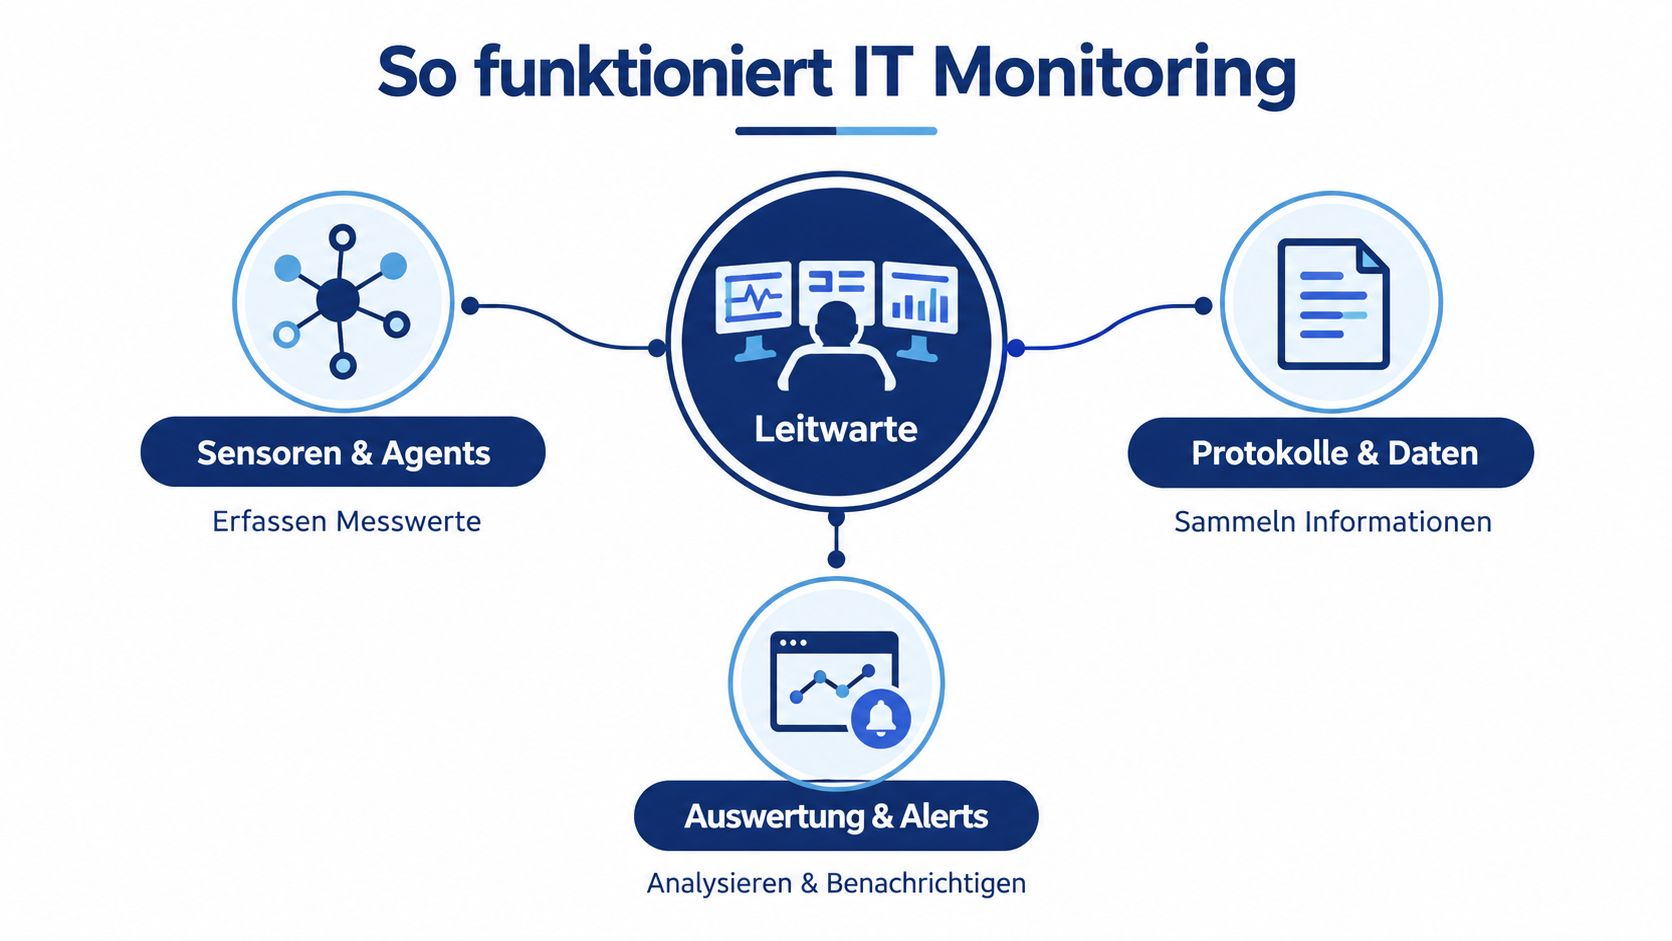
Stellen Sie sich eine moderne Produktionshalle vor. Niemand würde dort blind an der Maschine arbeiten, ohne Anzeigen, Kontrollleuchten und einen Blick in die Leitwarte. IT Monitoring Software funktioniert ähnlich, nur eben für Server, Anwendungen, Netze und Protokolle. Sie sammelt Signale, ordnet sie ein und meldet, wenn etwas aus dem Takt gerät.
Vom Messwert zum Ereignis
Der erste Baustein sind Sensoren oder Agents. Sie lesen Werte aus, etwa CPU-Last, Antwortzeiten, Speicher, Verbindungen oder Statusmeldungen. Diese Werte allein sind noch keine Entscheidung, sie sind wie Temperaturanzeigen in einem Maschinenraum.
Der zweite Baustein ist die Korrelation. Hier wird aus vielen Einzelwerten ein Zusammenhang. Wenn ein Server langsamer wird, weil gleichzeitig ein Dienst hängt und das Netz viele Fehler zeigt, erkennt gutes Monitoring diese Beziehung. Genau das verhindert, dass Teams zehn verschiedene Bildschirme prüfen müssen, um eine einzige Ursache zu finden.
Kernprinzip: Monitoring sammelt nicht nur Daten, es übersetzt Daten in handlungsrelevante Ereignisse.
Der dritte Baustein sind Alerts. Ein Alarm sollte nicht bloß „rot“ zeigen, sondern erklären, was betroffen ist, wie dringend es ist und wohin es gehört. Sonst gewöhnt sich das Team an Alarmrauschen und reagiert irgendwann zu spät.
Full-Stack heißt: mehr als Server
Klassisches Monitoring fragt oft nur, ob ein System lebt. Full-Stack-Observability geht weiter, sie verbindet Infrastruktur, Anwendung, Netzwerk, Logdaten und oft auch Nutzererlebnis. In verteilten Umgebungen reicht ein einzelner Schwellwert nicht mehr aus, weil Ursachenketten über mehrere Ebenen laufen.
Die Fraunhofer-Marktanalyse zu „Überwachung und Störungserkennung in vernetzten IT-Systemen“ ordnet Monitoring-Werkzeuge deshalb als eigenständige Marktklasse ein, die Unternehmen bei der Auswahl geeigneter Werkzeuge für verteilte IT-Systeme unterstützt. Das passt gut zur Realität in KMU, denn dort sind Umgebungen selten sauber getrennt. Ein Fehler im Maildienst kann die Anwendung verlangsamen, und ein Change im Netzwerk kann plötzlich alles andere mitziehen. Fraunhofer-Marktanalyse
Wie die Bausteine zusammenarbeiten
- Infrastruktur-Monitoring schaut auf Server, Speicher, Virtualisierung und Cloud-Ressourcen.
- Anwendungs-Monitoring prüft, wie Programme antworten und wo sie hängen.
- Netzwerk-Monitoring zeigt Störungen, Latenzen und Verbindungsprobleme.
- Log-Monitoring sammelt Hinweise aus Protokollen, damit Fehler nicht nur gemessen, sondern auch erklärt werden.
Wenn diese Ebenen zusammenlaufen, entsteht kein Datensilo, sondern ein Arbeitsbild. Genau das ist der Unterschied zwischen „Wir sehen viel“ und „Wir wissen, was zu tun ist“.
Laut dem BSI veröffentlicht das Amt monatlich ein aktuelles IT-Sicherheits-Lagebild mit Statistiken und Bewertungen und zusätzlich regelmäßige statistische Übersichten zur IT-Sicherheitslage. Für Monitoring ist das ein guter Anker, weil Sicherheits- und Betriebsinformationen heute dauerhaft aktualisiert werden müssen, nicht nur einmal im Quartal. BSI Lageberichte-Bereich
Welchen konkreten Nutzen Monitoring für KMU schafft
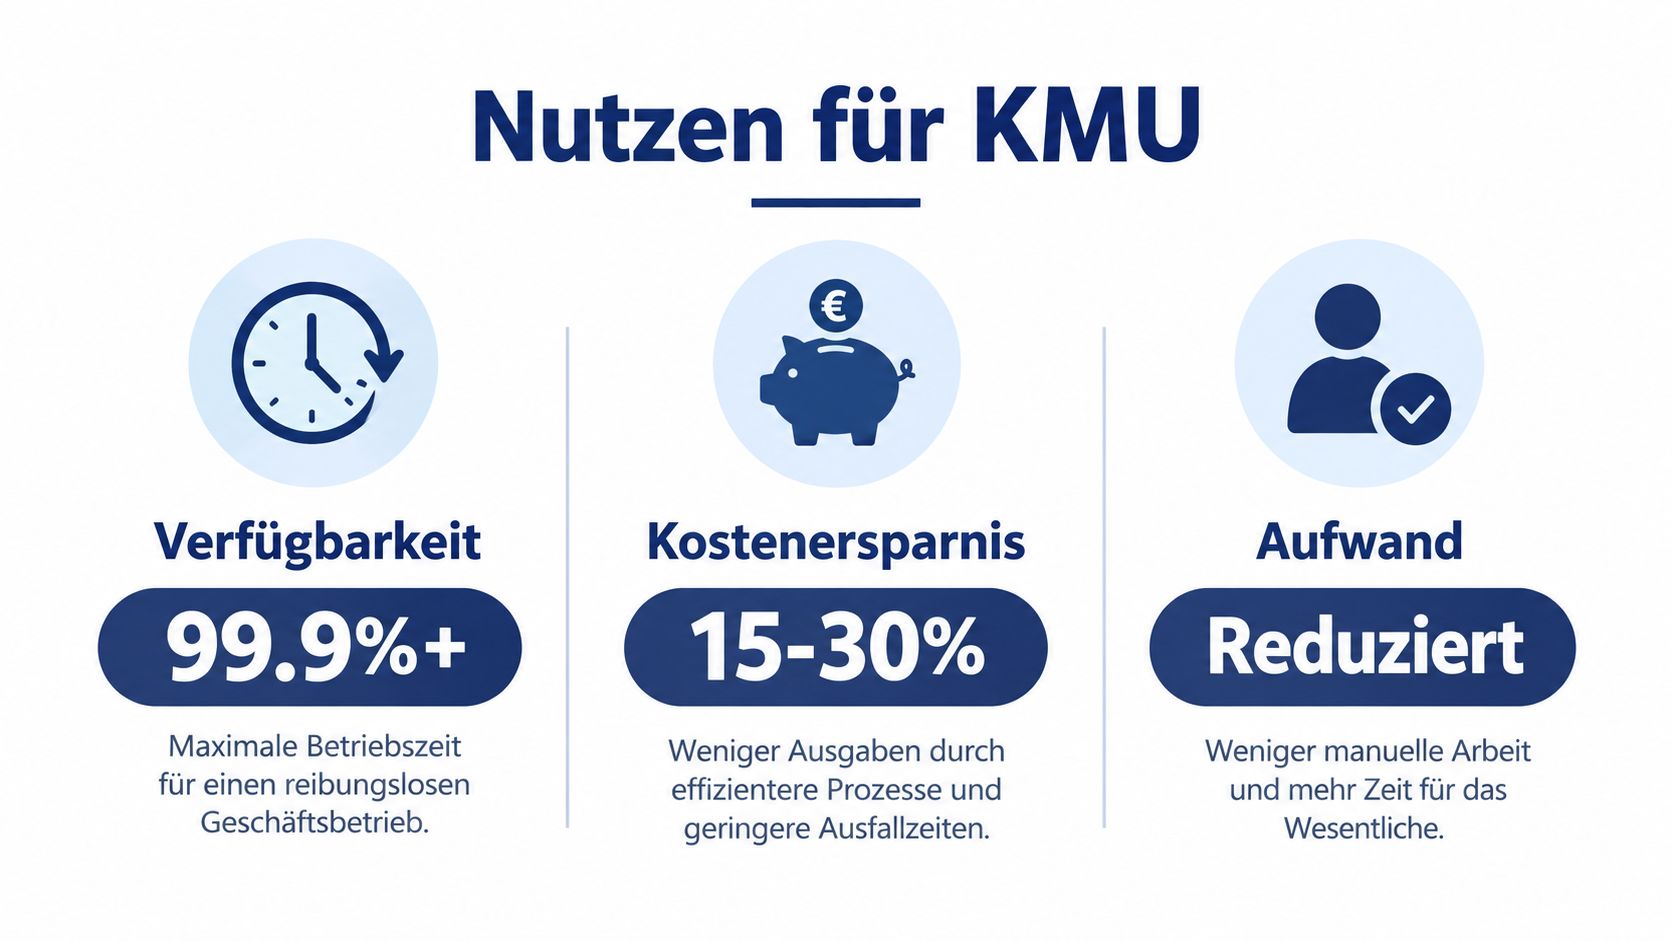
In der Praxis geht es selten um die Technik selbst. Ein Ausfall trifft kein Dashboard, sondern den Betrieb, die Kunden und oft auch den Umsatz. Monitoring schafft deshalb vor allem drei Dinge, Verfügbarkeit, Kostenkontrolle und Nachweisbarkeit.
Verfügbarkeit ist kein Gefühl
Verfügbarkeit braucht einen festen Maßstab, sonst bleibt sie bloß ein Eindruck. Das BSI beschreibt Verfügbarkeitsanforderungen über Klassen, und in VK 4 liegt die Zielverfügbarkeit bei 99,999 %, also rechnerisch bei nur etwa 5,25 Minuten Ausfallzeit pro Jahr. Das ist ein Orientierungswert für Systeme, bei denen schon kurze Unterbrechungen spürbar sind. BSI Hochverfügbarkeit
Für ein KMU heißt das: Nicht nur der Server muss laufen, auch das Monitoring selbst muss zuverlässig messen, alarmieren und eskalieren. Sonst fehlt genau dann der Blick auf die Lage, wenn es darauf ankommt. Die Überwachung sollte also so verlässlich sein wie die Systeme, die sie absichert.
Ausfälle kosten mehr als Nerven
Eine aktuelle Studie zu Observability-Ausfällen nennt für Deutschland durchschnittliche jährliche Kosten schwerwiegender Ausfälle von 169 Millionen US-Dollar pro Unternehmen und sagt, dass 46 % der deutschen Befragten mindestens wöchentliche kritische Ausfälle erleben. Als Hauptursachen werden Netzwerkstörungen, Dritt- oder Clouddienste sowie Hardwarefehler und Umgebungsänderungen genannt. New Relic Pressemitteilung
Im Alltag eines KMU zeigt sich das sehr direkt. Wenn ein Fehler nicht schnell eingegrenzt wird, verlängert sich die Suche nach der Ursache, und mit jeder Minute wachsen Folgekosten, Druck im Team und Frust auf Kundenseite. Monitoring ist deshalb eine finanzielle Schadensbremse, bevor Ausfälle zu Folgekosten werden.
Nachweise für Führung und Aufsicht
Ein zweiter Nutzen liegt in der Dokumentation. Das NIS-2-Umsetzungsgesetz ist in Deutschland in Kraft, und die Meldepflichten sehen eine 24-Stunden-Erstmeldung, eine 72-Stunden-Zwischenmeldung und einen Abschlussbericht nach einem Monat vor. BSI zu NIS-2
Damit wird Monitoring auch zum Nachweiswerkzeug. Wer Warnungen, Reaktionen und Behebungen sauber protokolliert, kann gegenüber Geschäftsführung, Prüfern oder Aufsicht zeigen, was passiert ist und wie schnell reagiert wurde. Gerade in Produktion, Klinik oder Sozialwirtschaft zählt dieser Beleg oft ebenso viel wie die eigentliche technische Maßnahme.
Die wichtigsten Funktionen verständlich erklärt
IT Monitoring Software wirkt erst dann im Alltag, wenn mehrere Funktionen zusammenspielen. Ein einzelnes Dashboard hilft wenig, ein einzelner Alarm auch. Entscheidend ist das Zusammenspiel aus Messung, Alarmierung, Darstellung und Berichtswesen. Wie bei einem Auto reicht ein Tacho allein nicht aus, auch Ölstand, Warnlampen und Bordcomputer müssen zusammen ein Bild liefern.
Monitoring und Metriken
Am Anfang stehen Messwerte. Sie zeigen, ob ein Dienst normal reagiert, ob ein Server Last trägt oder ob Netzverbindungen auffällig werden. Ohne saubere Metriken fehlt dem Team die Grundlage, denn dann bleibt jede Aussage über „langsam“ oder „instabil“ nur ein Eindruck.
Der Nutzen zeigt sich im Alltag schnell. Wenn der Ticket-Dienst langsamer wird, sieht die IT nicht nur die Beschwerde, sondern auch, ob die Ursache in der Anwendung, der Datenbank oder der Infrastruktur liegt. Monitoring spart hier Zeit, weil es von der Meldung zur Ursache führt.
Intelligente Alerts statt Alarmflut
Ein Alarm hilft nur, wenn er relevant ist. Schwellenwerte allein reichen oft nicht, weil sie zu viele Einzelsignale erzeugen. Besser sind Alerts, die zusammenhängende Symptome bündeln und die wahrscheinlich betroffene Komponente markieren.
Ein Switch meldet Paketverluste, gleichzeitig steigen Antwortzeiten in der Warenwirtschaft und ein Logeintrag zeigt Verbindungsabbrüche. Dann muss niemand drei Tickets als drei getrennte Probleme behandeln. Das System sollte daraus einen klaren Vorfall machen, nicht einen Stapel kleiner Störungen.
Dashboards für unterschiedliche Rollen
Nicht jede Rolle braucht dieselbe Sicht. Die IT sieht technische Details, die Bereichsleitung eher Servicezustände und Trends. Die Geschäftsführung will erkennen, ob die wichtigsten Dienste stabil laufen und ob Maßnahmen Wirkung zeigen.
Ein gutes Dashboard beantwortet die Frage der jeweiligen Rolle, nicht die Lieblingsfrage des Tools.
SLA-Messung und Reporting
Berichte dienen als Steuerungswerkzeug, nicht als Ablage. Sie zeigen, ob interne Serviceziele erreicht werden, wo wiederkehrende Engpässe liegen und welche Systeme ständig Aufmerksamkeit brauchen. Für Hochverfügbarkeit gilt zusätzlich, die Überwachung selbst muss mitgedacht und sauber betrieben werden.
So entsteht aus einem Werkzeug ein Steuerungssystem. Nicht die Menge an Daten entscheidet, sondern ob Daten in klare Handlungen, Verantwortlichkeiten und Nachweise übersetzt werden.
So wählen Sie die passende IT Monitoring Software aus
Die Auswahl scheitert im Mittelstand oft an derselben Stelle. Teams vergleichen viele Funktionen, aber nicht die Frage, welche Betriebsprobleme wirklich gelöst werden sollen. Darum hilft eine Entscheidungsmatrix mehr als eine lange Produktliste.
| Kriterium | Worauf KMU achten sollten | Warnsignal bei Anbietern |
|---|---|---|
| Abdeckung | Infrastruktur, Anwendungen, Logs und Netzwerk sollten zusammenpassen | Nur einzelne Inseln, keine Verbindung zwischen den Ebenen |
| Skalierbarkeit | Das System muss mit Standorten, Diensten und neuen Anwendungen wachsen | Nur für kleine Umgebungen brauchbar |
| Integrationen | Tickets, Mail, Chat und Serviceprozesse sollten angebunden werden können | Jeder Alarm muss manuell weitergereicht werden |
| Alarmqualität | Meldungen brauchen Kontext, Priorität und Zuständigkeit | Viele Warnungen ohne Einordnung |
| Usability | Auch Nicht-Spezialisten müssen Zustände verstehen können | Nur für wenige Experten bedienbar |
| Sicherheit und Compliance | Protokollierung, Rollen und Nachweise gehören dazu | Keine klare Aussage zu Audit- oder Nachweisdaten |
| Kostenmodell | Laufende Kosten, Betrieb und Pflege mitdenken, nicht nur Lizenzpreis | Niedriger Einstieg, hohe Folgekosten |
Wer mehr als nur den Lizenzpreis betrachtet, landet schnell bei der TCO-Frage. Dazu passt auch der Blick auf die wirtschaftliche Gesamtrechnung bei TCO-Berechnung, denn ein günstiges Tool kann teuer werden, wenn es Alarme streut, keine Nachweise liefert oder nur mit viel Pflege funktioniert.
Isoliertes Tool oder integrierte Observability
Ein Spezialtool kann sinnvoll sein, wenn ein einzelnes Problem im Fokus steht, etwa ein bestimmter Dienst oder eine klar abgegrenzte Infrastruktur. Sobald aber mehrere Systeme zusammenwirken, wird die isolierte Sicht schnell eng. Dann braucht es eher eine integrierte Plattform, die Ereignisse korreliert und Kontext liefert.
Ein weiteres Entscheidungskriterium ist die Frage, wer damit arbeiten soll. Wenn nur eine Spezialistin das System versteht, entsteht Abhängigkeit. Wenn IT, Leitung und externe Dienstleister dieselben Zustände anders tief sehen können, wird die Lösung tragfähiger.
Merksatz für die Auswahl: Kaufen Sie nicht zuerst ein Tool, kaufen Sie zuerst ein Betriebsmodell.
Im Umfeld von Managed Services fällt manchmal auch der Name GSL Groß GmbH, wenn Unternehmen nicht nur Software, sondern auch laufenden Betrieb, Monitoring und Reaktionswege aus einer Hand suchen. Solche Angebote funktionieren besonders dann gut, wenn der Prozess klar, dokumentiert und mit festen Zuständigkeiten hinterlegt ist.
Implementierung in fünf schlanken Phasen
Eine saubere Einführung muss nicht groß und schwer sein. Sie braucht vor allem Reihenfolge. Wer einfach Sensoren ausrollt, ohne Zielbild und Verantwortung, erzeugt schnell nur zusätzliche Arbeit.
1. Inventar und Zielbild
Am Anfang steht eine ehrliche Liste. Welche Systeme sind kritisch, welche Anwendungen hängen daran, und welche Ausfälle tun wirklich weh? Danach folgt die Frage, wer im Ernstfall informiert wird und wer Entscheidungen trifft.
Ohne diese Klärung bleibt jedes Monitoring unscharf. Dann misst man vieles, aber nicht das Richtige. Für KMU ist das der häufigste Stolperstein, weil Technik gern vor Organisationsklärung kommt.
2. Sensoren und Baseline aufbauen
Danach werden die wichtigsten Messpunkte eingerichtet. Dabei geht es nicht darum, sofort alles zu erfassen, sondern die kritischen Dienste sichtbar zu machen. Erst wenn ein Normalzustand erkennbar ist, lassen sich Abweichungen sinnvoll beurteilen.
Die Baseline ist wichtig, weil jeder Betrieb anders tickt. Was in der Nacht normal ist, kann am Morgen ein Alarm sein. Wer diesen Bezug nicht sauber aufbaut, erzeugt unnötige Meldungen.
3. Alarme tuning statt Alarmflut
Jetzt wird geschärft. Schwellenwerte, Eskalationsregeln und Zuständigkeiten werden so angepasst, dass relevante Meldungen durchkommen und Nebengeräusche verschwinden. Das spart Nerven und verhindert, dass das Team die Warnungen irgendwann ignoriert.
Typische Stolperfalle ist die falsche Priorisierung. Alles als kritisch zu markieren wirkt zunächst sicher, endet aber oft im Gegenteil. Gute Alarmierung ist streng, aber nachvollziehbar.
4. Dashboards und Berichtspflicht
Im nächsten Schritt werden Sichtweisen gebaut, die zu Rollen passen. IT braucht technische Tiefe, Geschäftsführung braucht Übersicht, und Datenschutz oder Compliance brauchen Nachweise. So wird Monitoring vom Werkzeug zur gemeinsamen Entscheidungsgrundlage.
5. Test, Dokumentation und Übergabe
Zum Schluss kommen Probeläufe, Notfalltests und saubere Dokumentation. Wer diese Phase überspringt, merkt erst im Ernstfall, dass Zuständigkeiten unklar sind oder ein Alarmweg nicht funktioniert. Gerade mit Blick auf NIS2 ist es sinnvoll, Nachweise von Beginn an mitzudenken, nicht erst im Audit.
Ein schlanker Rollout lebt davon, dass jeder Schritt abgeschlossen wird, bevor der nächste beginnt. Dann bleibt das System beherrschbar, auch wenn nur wenig interne IT-Zeit zur Verfügung steht.
Managed Services als Alternative zum Eigenbetrieb
Für viele KMU ist die eigentliche Frage nicht, welches Tool sie kaufen. Die Frage ist, wer den Betrieb täglich sauber mitträgt. Eigenbetrieb lohnt sich, wenn intern genug Know-how, Zeit und Bereitschaft für Pflege, Updates und Alarmbearbeitung vorhanden sind. Fehlt das, wird Monitoring schnell zur Nebenaufgabe, und Nebenaufgaben verlieren im Alltag fast immer gegen das Tagesgeschäft.
Ein Managed-Service-Modell verschiebt diese Last in einen klaren Rahmen. In der Praxis umfasst das meist kontinuierliches Monitoring, fest definierte Reaktionswege, Patch- und Vulnerability-Monitoring, Backup-Kontrollen und regelmäßige Reports für die Geschäftsführung. Einen solchen Ansatz beschreibt auch Managed Services IT, wenn Betrieb, Überwachung und Support nicht getrennt, sondern als laufender Service gedacht werden.
Gerade für Unternehmen mit NIS2-Druck ist das sinnvoll. Meldwege, Dokumentation und technische Nachweise müssen sitzen, und zwar auch dann, wenn intern gerade niemand Zeit hat. Ein regionaler Partner mit Remote- und Vor-Ort-Support kann hier helfen, weil er nicht nur Alarmmeldungen sieht, sondern auch die Umsetzung begleitet.
Wer sich für Managed Services entscheidet, sollte auf drei Dinge achten, klare SLAs, transparente Reports und nachvollziehbare Eskalation. Wenn diese Punkte sauber geregelt sind, wird Monitoring nicht zur Zusatzlast, sondern zur planbaren Betriebsleistung.
Wenn Sie IT Monitoring nicht nur als Tool, sondern als Betriebsmodell verstehen wollen, sprechen Sie mit der GSL Groß GmbH über Monitoring, Managed Services und NIS2-taugliche Nachweise im Alltag. Auf GSL Groß GmbH finden Sie einen regionalen Ansprechpartner für KMU, die Verfügbarkeit, Sicherheit und klare Zuständigkeiten zusammenbringen wollen.