
Am zweiten Dienstag im Monat beginnt in vielen deutschen IT-Abteilungen derselbe Ablauf: Updates werden synchronisiert, Freigaben geprüft, Wartungsfenster abgestimmt und ein Dashboard färbt sich grün. Trotzdem kann am nächsten Morgen ein Server fehlen, ein notwendiger Neustart ausstehen oder ein geschäftskritischer Dienst nicht laufen. Genau dort liegt die operative Realität von Patch Management für Windows Server. Ein erfolgreicher Rollout ist nicht dasselbe wie ein sicherer, nachweisbarer Patch-Stand.
Für den Mittelstand in Rheinland-Pfalz und Hessen verschärft sich die Situation durch NIS2. Patchen, testen und dokumentieren gehören nicht mehr nur zur technischen Routine. Verantwortliche müssen zeigen können, welche Systeme erfasst sind, warum ein Update freigegeben wurde, welche Ausnahmen bestehen und wie Risiken bis zur Behebung kontrolliert werden.
Inhaltsverzeichnis
- Die Illusion grüner Dashboards und der NIS2-Druck
- WSUS, ConfigMgr und Intune im Mittelstands-Check
- Den Patch Tuesday strategisch und risikobasiert nutzen
- Automatisierung mit Sicherheitsnetz und echten Validierungen
- Notfall-Rollback und der Umgang mit fehlerhaften Updates
- Patch-Management als revisionssicherer NIS2-Baustein
Die Illusion grüner Dashboards und der NIS2-Druck
Ein Dashboard kann grün leuchten, während ein Server noch auf den Neustart wartet oder der aktuelle Patch nicht aktiv ist. Der gemeldete Installationsstatus zeigt zunächst nur, was das Management-Tool verarbeitet hat. Er sagt wenig darüber aus, ob alle relevanten Systeme erfasst wurden und der Betrieb tatsächlich dem erwarteten Stand entspricht.
Ein deutsches Praxisbeispiel zeigt die Größenordnung dieser Lücke. In einem Konzern mit 40.000 PCs und Servern an 70 Standorten meldete das eingesetzte Tool konstant eine Erfolgsquote von 95 bis 98 Prozent pro Patch. Eine Netzprüfung fand dagegen nur 70 Prozent tatsächlich aktuelle Systeme. Laut derselben Studie prüften fast 47 Prozent der Unternehmen die gemeldeten Ergebnisse lediglich stichprobenartig oder gar nicht. ComputerWoche beschreibt die Diskrepanz zwischen gemeldeten und realen Patch-Ständen.
Was ein Statusbericht nicht beweist
Der Status „erfolgreich“ kann trotz ausstehendem Neustart erscheinen. Auch ein fehlerhafter Agent, veraltete Inventardaten oder eine unterbrochene Verbindung verfälschen die Bewertung. Besonders riskant sind Server, die technisch vorhanden sind, aber in keinem aktuellen Asset-Inventar auftauchen.
Eine belastbare Kontrolle verbindet mehrere Prüfebenen:
- Installationsstatus: Ist das konkrete Update im Betriebssystem registriert?
- Aktiver Systemzustand: Wurde der erforderliche Neustart durchgeführt und läuft der erwartete Build?
- Dienstestatus: Funktionieren Active Directory, DNS, SQL, ERP-Schnittstellen und abhängige Dienste?
- Asset-Abgleich: Deckt der Scan die vollständige Serverlandschaft ab?
- Netzsicht: Werden auch Systeme erkannt, die vom Management-Tool nicht ordnungsgemäß verwaltet werden?
Praktische Regel: Ein Dashboard ist ein Hinweisgeber, kein Beweis. Erst der Abgleich zwischen Tool, Systemzustand, Netzprüfung und Asset-Inventar macht aus einem Rollout einen belastbaren Nachweis.
NIS2 macht den Prozess prüfbar
Seit dem 6. Dezember 2025 gilt das NIS2-Umsetzungsgesetz in Deutschland. Betroffene Einrichtungen müssen sich binnen drei Monaten beim BSI registrieren. Die dokumentierten Angaben zur deutschen NIS2-Umsetzung und zur Registrierungspflicht zeigen, warum Wartungsfenster und Nachweise in den Compliance-Prozess gehören.
Für Kliniken, Sozialträger und produzierende Unternehmen braucht die Geschäftsführung eine nachvollziehbare Prozesskette statt einer bunten Übersicht. Dokumentiert werden müssen die Bewertung der Schwachstelle, die Freigabe des Wartungsfensters, getestete Systeme, fehlgeschlagene Server und kompensierende Maßnahmen für nicht patchbare Systeme. Hotpatching kann bei passenden Windows-Servern Neustarts reduzieren, ersetzt aber weder die Prüfung des aktiven Zustands noch die Dokumentation von Ausnahmen.
Das BSI beschreibt Patch- und Änderungsmanagement als kontrollierten, überwachten und kontinuierlich zu optimierenden Prozess. Der monatliche Patch-Zyklus am zweiten Dienstag, der sogenannte Patch Tuesday, bietet dafür den organisatorischen Bezugspunkt. Die BSI-Vorgaben zu Patch- und Änderungsmanagement verbinden Technik, Freigabe, Überwachung und Dokumentation.
WSUS, ConfigMgr und Intune im Mittelstands-Check
Die Toolwahl entscheidet nicht allein über Sicherheit. Sie entscheidet darüber, wie zuverlässig Inventar, Freigabe, Rollout und Nachprüfung im Alltag funktionieren. Für einen kleinen Standort mit wenigen Windows-Servern kann WSUS völlig ausreichen. Eine verteilte Organisation mit Außenstellen, wechselnder Konnektivität und unterschiedlichen Verantwortlichkeiten braucht dagegen häufig stärkere Orchestrierung.
WSUS bleibt sinnvoll, wenn die Umgebung überschaubar ist
Windows Server Update Services, kurz WSUS, ist attraktiv, wenn Updates lokal gesteuert, klassifiziert und in definierten Gruppen freigegeben werden sollen. Für eine konzentrierte Umgebung mit wenigen Serverrollen, stabiler Netzwerkverbindung und klaren Wartungsfenstern ist die Lösung oft ausreichend.
Die Schwächen liegen weniger in der Grundidee als im Betrieb. Bereinigung, Synchronisation, Genehmigungen, Gruppenstruktur und Datenbankpflege müssen organisiert werden. Außerdem darf der WSUS-Server selbst nicht zum blinden Fleck werden. Das BSI meldete Ende Oktober 2025, dass in Deutschland rund 280 WSUS-Server aus dem Internet erreichbar waren. Dem CERT-Bund lagen dabei keine Informationen über deren Patchstand vor. Die BSI-Warnung zu öffentlich erreichbaren WSUS-Servern unterstreicht, dass Update-Infrastruktur geschützt und überwacht werden muss.
ConfigMgr bietet Kontrolle für komplexere Flotten
Microsoft Endpoint Configuration Manager, früher SCCM und heute meist ConfigMgr genannt, passt besser zu Umgebungen mit vielen Servergruppen, detaillierten Sammlungen, Wartungsfenstern und bestehenden Softwareverteilungsprozessen. Administratoren können Installationen stärker sequenzieren, Statusinformationen auswerten und weitere Betriebsaufgaben zentral einbinden.
Der Preis ist operative Komplexität. ConfigMgr braucht saubere Rollen, Boundary-Strukturen, Distribution Points, Rechtekonzepte und Pflege. Wer nur wenige Server verwaltet, baut damit leicht mehr Infrastruktur auf, als der Anwendungsfall rechtfertigt.
Intune eignet sich für cloudorientierte und hybride Szenarien
Microsoft Intune spielt seine Stärken bei cloudverwalteten Geräten, standardisierten Richtlinien und verteilten Arbeitsplätzen aus. Gerade bei Organisationen mit vielen Außenstellen kann die Abhängigkeit von einem zentralen lokalen Updatepunkt sinken. Für klassische Windows-Server ist die Eignung jedoch nicht pauschal mit der Verwaltung von Endgeräten gleichzusetzen. Rollen, Serverbetriebssysteme, Abhängigkeiten und Wartungsfenster müssen separat bewertet werden.
Eine verständliche Einordnung der Plattform bietet der Überblick zu Microsoft Intune. In hybriden Umgebungen kann eine Kombination aus ConfigMgr, Intune und weiteren Microsoft-Diensten sinnvoll sein, sofern Zuständigkeiten und Statusquellen eindeutig festgelegt sind.
| Kriterium | WSUS (Lokal) | ConfigMgr (SCCM) | Intune (Cloud) |
|---|---|---|---|
| Geeignete Umgebung | Überschaubare lokale Windows-Server-Landschaft | Komplexe, zentral gesteuerte Server- und Client-Flotte | Verteilte, cloudorientierte und hybride Verwaltung |
| Freigabesteuerung | Klassifizierung und Gruppenfreigaben | Detaillierte Sammlungen und Wartungsfenster | Richtlinien und cloudbasierte Updateverwaltung |
| Außenstellen | Abhängig von lokaler Infrastruktur | Mit geeigneter Verteilung gut steuerbar | Besonders praktisch bei wechselnder Standortanbindung |
| Betriebsaufwand | Moderat, aber regelmäßige Pflege nötig | Hoch, dafür umfassende Steuerungsmöglichkeiten | Weniger lokale Infrastruktur, aber Cloud- und Identitätsabhängigkeiten |
| Hauptrisiko | Veraltete oder exponierte Update-Infrastruktur | Fehlkonfiguration und komplexe Zuständigkeiten | Unklare Servereignung und fehlende lokale Abhängigkeitstests |
Die Entscheidung sollte daher nicht mit einer Feature-Liste beginnen. Prüfen Sie zuerst Serverrollen, Außenstellen, Abhängigkeiten, Offline-Szenarien, Wiederanlaufanforderungen und den tatsächlichen Dokumentationsbedarf.
Den Patch Tuesday strategisch und risikobasiert nutzen
Ein grünes Dashboard kann täuschen: Ein Server meldet den Patch als installiert, während ein Dienst nicht läuft, eine Abhängigkeit ungeprüft bleibt oder ein Neustart aussteht. Patch Tuesday ist deshalb kein automatischer Freigabetermin, sondern ein fester Prüfpunkt für tatsächliche Patch-Quoten, Betriebsrisiken und NIS2-Nachweise.
Microsoft veröffentlicht am zweiten Dienstag eines Monats reguläre kumulative Sicherheitsupdates. Bei akuter Bedrohung kommen Out-of-Band-Updates ausserhalb dieses Rhythmus hinzu. Die BSI-Empfehlungen zum Windows-Server-Patchmanagement nennen dafür Identifikation, Bewertung, Test, Freigabe und dokumentierte Umsetzung. Für die Praxis gehört zusätzlich eine Gegenprüfung dazu: Ist der Patch wirklich aktiv, und funktionieren die abhängigen Dienste?
Der Freigabeprozess braucht Ringe
Beginnen Sie mit einer kleinen Testgruppe, deren Konfiguration der Produktion möglichst nahekommt, ohne einen zentralen Geschäftsprozess zu gefährden. Danach folgt eine Pilotgruppe mit unterschiedlichen Serverrollen und repräsentativen Anwendungen. Erst erfolgreiche Überwachung und Funktionstests rechtfertigen die Ausweitung.
Domain Controller, DNS-Server und zentrale Datenbankrollen erhalten eine eigene Entscheidung. Die Reihenfolge richtet sich nach Abhängigkeiten und Wiederanlaufzeiten, nicht nach den Standardgruppen des Tools.
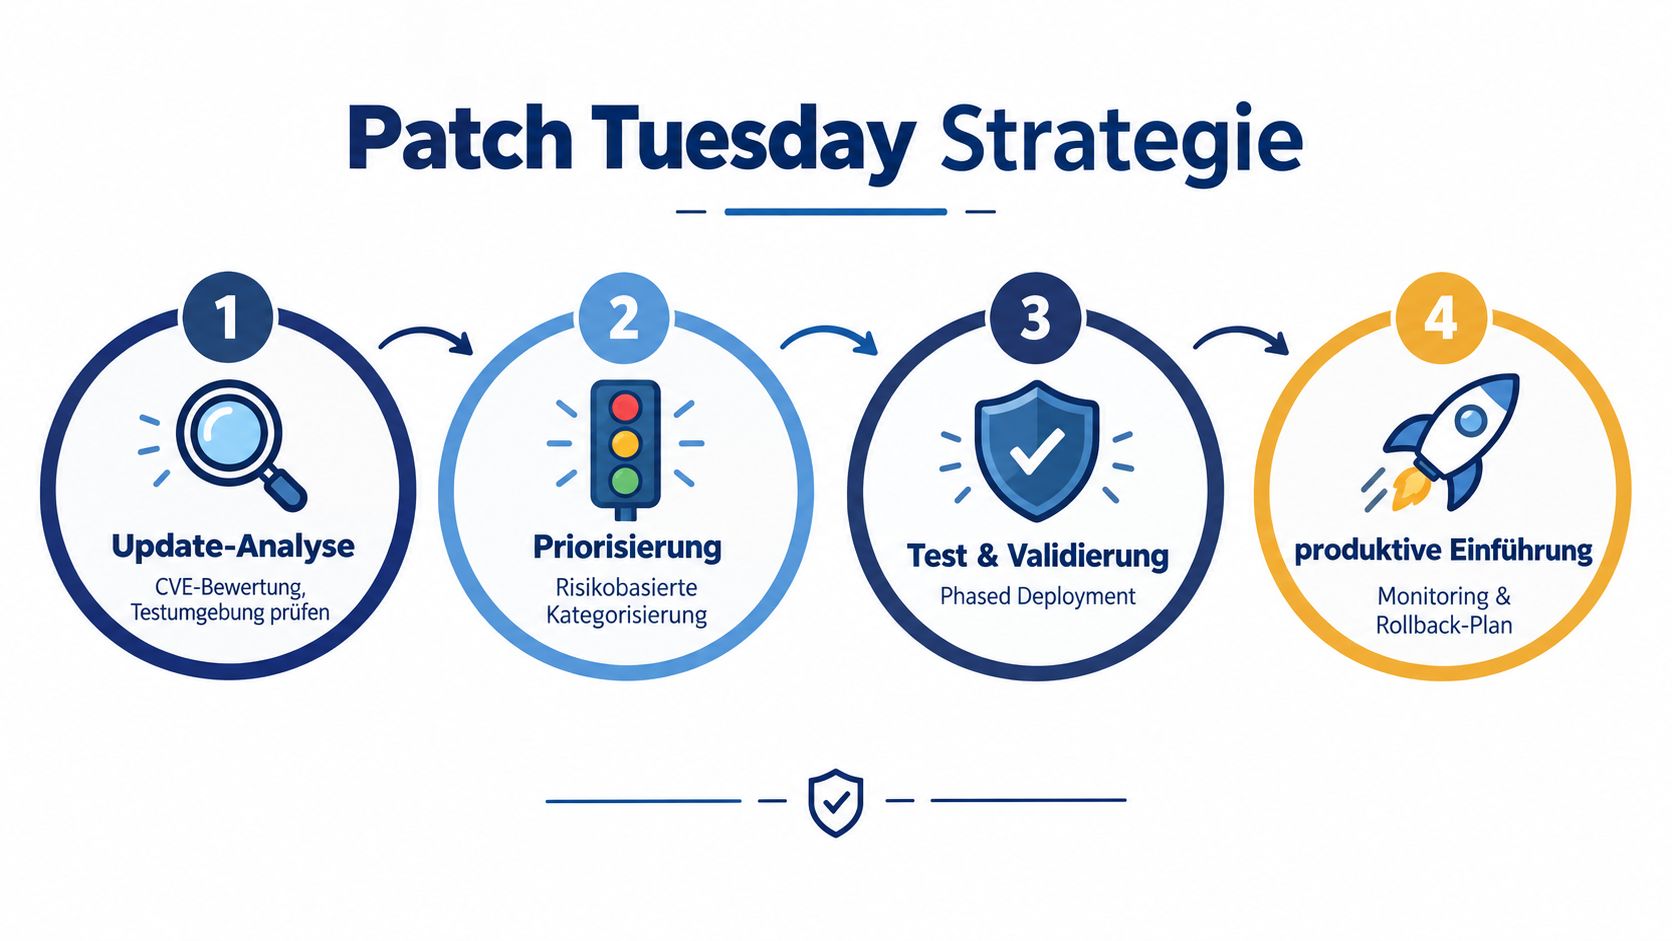
- Analyse: Update-Inhalte, bekannte Probleme, betroffene Rollen und Abhängigkeiten prüfen.
- Priorisierung: Exponierte und geschäftskritische Systeme zuerst bewerten.
- Pilotierung: Updates auf kontrollierbaren, repräsentativen Systemen installieren.
- Produktivsetzung: Nur bei erfüllten Prüfkriterien ausweiten und den Rückweg bereithalten.
- Nachweis: Gemeldete Installationen mit Neustartstatus, Dienstprüfung und tatsächlicher Erreichbarkeit abgleichen.
Hotpatching reduziert Reboots, ersetzt aber keine Architektur
Für Windows Server 2022 Datacenter: Azure Edition wurde der Hotpatch-Updatesupport bis Oktober 2027 verlängert. Die dazu genannten Hotpatching-Informationen ermöglichen bei geeigneten Systemen weniger geplante Neustarts, sofern Architektur und Lizenzmodell passen.
Hotpatching passt nicht zu jeder Serverrolle. Replikation, Rollenwechsel und koordinierte Wartungsfenster können weiterhin Neustarts verlangen. Auch ein hotgepatchter Server muss auf Dienste, Ereignisprotokolle und Anwendungen geprüft werden.
Schneller patchen ist nicht automatisch sicherer. Sicherer ist der schnellste Prozess, der Risiko, Abhängigkeiten, Rückfalloption und Nachweis gemeinsam beherrscht.
Für KMU, Kliniken und Sozialträger ist eine gemischte Strategie praktikabel: Hotpatching für geeignete Rollen, abgestimmte Wartungsfenster mit Failover und Wiederanlaufprüfung für kritische Kernsysteme.
Automatisierung mit Sicherheitsnetz und echten Validierungen
Automatisierung nimmt Routinearbeit ab, aber sie beseitigt keine Verantwortung. Eine Richtlinie kann ein Update installieren. Sie kann nicht zuverlässig beurteilen, ob eine ERP-Schnittstelle fachlich funktioniert oder ob ein Dienst zwar gestartet, aber wegen eines Fehlers unbrauchbar ist.
Die Lösung trennt Download, Freigabe, Installation und Validierung. Updates dürfen vorab geladen werden, während die eigentliche Installation an definierte Wartungsfenster und Freigabebedingungen gebunden bleibt.
Vor dem Rollout
GPOs, Intune-Policies oder Skripte sollten nicht nur Installationszeiten definieren. Sie müssen auch Ausschlüsse, Neustartverhalten, Servergruppen und Eskalationen abbilden. Ein Skript, das einen Neustart erzwingt, ohne abhängige Dienste oder Clusterzustände zu berücksichtigen, automatisiert nicht Sicherheit, sondern das Ausfallrisiko.
Vor jedem Rollout gehören mindestens diese Prüfungen in den Ablauf:
- Inventarprüfung: Ist der Server bekannt, erreichbar und der richtigen Gruppe zugeordnet?
- Abhängigkeitstest: Sind Datenbanken, Schnittstellen, Cluster und Replikationen berücksichtigt?
- Freigabestatus: Ist das Update für diese Rolle und dieses Wartungsfenster genehmigt?
- Rückfallprüfung: Existieren getestete Backups, Snapshots oder Failover-Wege?
Nach dem Neustart zählt der Dienst, nicht der Ping
Ein Server kann auf ICMP reagieren und trotzdem unbrauchbar sein. Post-Patch-Checks sollten deshalb den tatsächlichen Dienstzustand prüfen. Bei einem SQL-Server gehört dazu beispielsweise die Erreichbarkeit der Instanz und die Prüfung relevanter Datenbankdienste. Bei einer ERP-Schnittstelle muss die Kommunikation zur Gegenstelle funktionieren. Bei Active Directory sind Replikation, DNS-Auflösung und Ereignisprotokolle wichtiger als ein einfacher Erreichbarkeitstest.
Ein geschlossener Prüfprozess sammelt:
- installierte KB- oder Build-Information,
- Status des erforderlichen Neustarts,
- Startzustand kritischer Dienste,
- relevante Fehler im Ereignisprotokoll,
- Abgleich mit dem Asset-Inventar,
- Ergebnis des Compliance-Scans.
Die Erfahrung mit der genannten Lücke zwischen gemeldeten und realen Patch-Ständen zeigt, warum Stichproben allein nicht genügen. Sie können ergänzend eingesetzt werden, dürfen aber nicht die einzige Kontrolle nach einem breiten Rollout sein. Einen praxisnahen Rahmen für die vorgelagerte technische Bewertung bietet der Vulnerability-Assessment-Leitfaden für KMU und Kliniken.
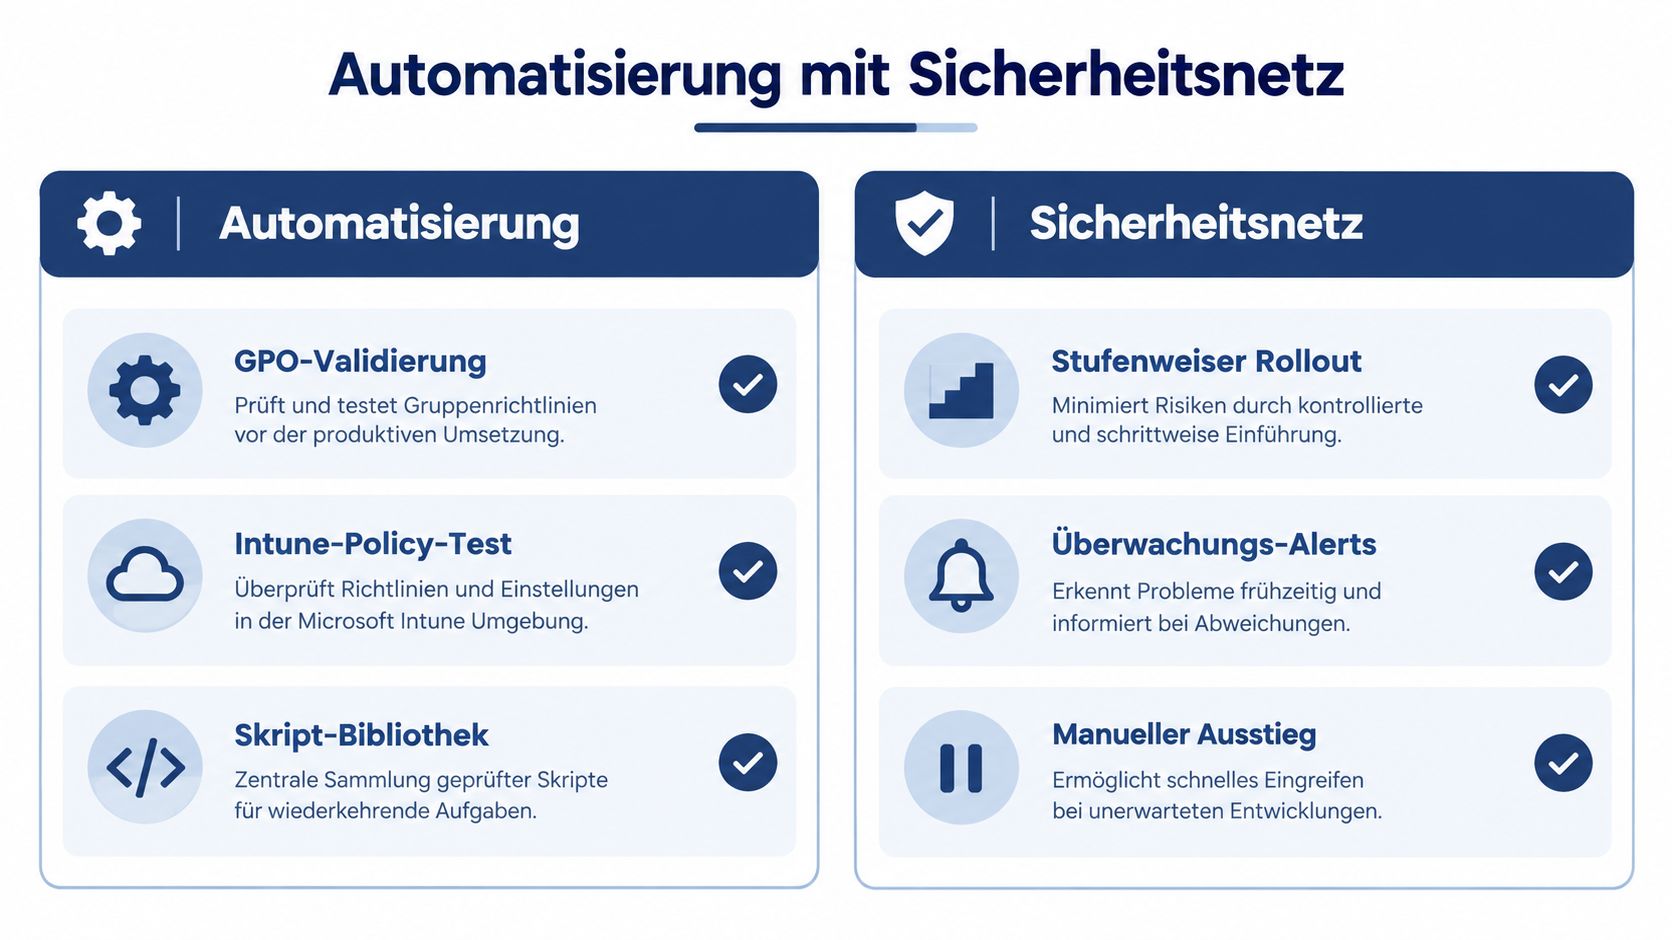
Ein Sicherheitsnetz braucht ausserdem einen manuellen Ausstieg. Wenn Fehlerraten steigen, Dienste nicht zurückkehren oder ein Herstellerproblem bekannt wird, muss der Rollout automatisch pausieren oder von einem Administrator angehalten werden. Gute Automatisierung schafft diese Entscheidungspunkte sichtbar, statt sie zu verstecken.
Notfall-Rollback und der Umgang mit fehlerhaften Updates
Ein fehlerhaftes kumulatives Update wird nicht dadurch harmlos, dass es offiziell freigegeben wurde. Treiber, Backup-Agenten, Sicherheitssoftware, Clusterkomponenten oder individuelle Anwendungen können nach einem Neustart anders reagieren als in der Testumgebung.
Erst stabilisieren, dann analysieren
Wenn ein produktiver Dienst nach dem Patch ausfällt, sollte das Team nicht gleichzeitig unkontrolliert deinstallieren, rebooten und Konfigurationen verändern. Zuerst werden betroffene Systeme isoliert, abhängige Dienste bewertet und der letzte funktionierende Zustand dokumentiert.
Ein pragmatischer Ablauf sieht so aus:
- Rollout stoppen: Freigaben in WSUS, ConfigMgr oder Intune für die noch nicht aktualisierte Gruppe pausieren.
- Auswirkung begrenzen: Betroffene Server aus dem kritischen Pfad nehmen, auf redundante Systeme umschalten oder Verbindungen kontrolliert reduzieren.
- Ursache eingrenzen: Updatehistorie, Ereignisprotokolle, Dienststatus, Treiber und Reboot-Zustand vergleichen.
- Gezielt zurückrollen: Wenn unterstützt und vertretbar, das fehlerhafte KB deinstallieren. Bei virtuellen Maschinen kann ein zuvor geprüfter Snapshot helfen.
- Wiederherstellen: Wenn Deinstallation oder Snapshot nicht ausreichen, Backup-Wiederherstellung und Notfallbetrieb aktivieren.
- Freigabe sperren: Das Update bleibt blockiert, bis Ursache, Herstellerhinweis und Gegenmassnahme bewertet sind.
Snapshots sind dabei kein Ersatz für Backups. Ein Snapshot kann bei einem konsistenten, kurzen Rückweg nützlich sein, bringt aber eigene Risiken mit. Datenbanken, Verzeichnisdienste und transaktionsintensive Systeme müssen nach der Wiederherstellung auf Konsistenz geprüft werden.
Kommunikation gehört zum technischen Verfahren
Ein Rollback ohne Kommunikation erzeugt Folgefehler. Der Service Desk, Fachbereich, Hersteller und die verantwortliche Führungskraft müssen wissen, welcher Dienst betroffen ist, welche Auswirkung besteht und welche Entscheidung als Nächstes ansteht. Jede Massnahme erhält einen Zeitstempel, einen Verantwortlichen und ein Ergebnis.
Bei NIS2-relevanten Einrichtungen muss zusätzlich bewertet werden, ob aus dem Updatefehler ein meldepflichtiger Sicherheitsvorfall oder eine erhebliche Betriebsstörung entstanden ist. Diese Einstufung darf nicht erst nach der technischen Reparatur beginnen. Sicherheitsverantwortliche und Geschäftsführung brauchen einen klaren Eskalationsweg, der bereits im Wartungsprozess hinterlegt ist.
Rollback-Regel: Ein Rückweg ist nur dann vorbereitet, wenn bekannt ist, wer ihn auslöst, welche Systeme betroffen sind und wie der korrekte Zustand nach der Wiederherstellung verifiziert wird.
Nach der Stabilisierung folgt die Ursachenanalyse. Prüfen Sie, ob die Testgruppe repräsentativ war, ob ein Treiber oder Agent fehlte, ob ein Neustart unterbrochen wurde und ob der Freigabezeitpunkt zu früh gewählt war. Das Ergebnis sollte in die nächste Patch-Tuesday-Planung einfliessen, nicht in einem Incident-Ticket verschwinden.
Patch-Management als revisionssicherer NIS2-Baustein
Ein Server kann laut Managementsystem aktuell erscheinen und trotzdem ungepatchte oder unbekannte Systeme enthalten. Für einen revisionssicheren Prozess zählt deshalb nicht die gemeldete Quote allein, sondern der belegte Zustand jedes Assets, einschliesslich erfolgreicher Validierung und dokumentierter Ausnahmen.
Patch Management Windows Server verbindet Asset-Inventar, Schwachstellenbewertung, Change-Freigabe, Rollout, Funktionsprüfung, Ausnahmebehandlung und Wiederherstellung. Für jeden Wartungslauf muss nachvollziehbar sein, welche Systeme im Scope waren, welche Updates freigegeben wurden, wann die Installation erfolgte, welche Dienste danach geprüft wurden und wie Fehler behandelt wurden.
Der Nachweis muss aus dem Betrieb entstehen
WSUS, ConfigMgr und Intune liefern Protokolle. Auditfähig werden diese Daten erst durch die Verbindung mit Rollen, Wartungsfenstern und begründeten Ausnahmen. Ein brauchbarer Report zeigt daher nicht nur Installationsquoten, sondern auch fehlende Neustarts, unbekannte Assets, ausstehende Nacharbeiten und kompensierende Schutzmassnahmen. Die gemeldete Patch-Quote muss gegen Inventar, Schwachstellenscan und Dienstestatus geprüft werden.
Für Geschäftsführung und IT-Leitung sind folgende Fragen entscheidend:
- Abdeckung: Sind alle Windows-Server und ihre Kritikalitätsklassen bekannt?
- Risikosteuerung: Werden internetnahe, zentrale und geschäftskritische Rollen priorisiert?
- Freigabe: Ist dokumentiert, wer Test und Produktion freigegeben hat?
- Wirksamkeit: Sind Update, Neustart und betroffene Dienste nach dem Rollout tatsächlich aktiv?
- Ausnahmen: Gibt es für nicht patchbare Systeme eine Begründung, Frist und Schutzmassnahme?
- Eskalation: Ist geregelt, wann IT-Sicherheit, Management und gegebenenfalls Behörden einbezogen werden?
Support-Ende verlangt einen anderen Kontrolltyp
Patchmanagement endet nicht mit der monatlichen Installation. Der Produktlebenszyklus gehört in dieselbe Kontrolle. Für Windows 10 endete der reguläre Support am 14. Oktober 2025. Für Unternehmen steht dabei kein ESU-Programm wie für Privatnutzer bereit. Systeme ohne reguläre Sicherheitsupdates benötigen deshalb eine eigene Risikobewertung, klare Verantwortlichkeit und einen dokumentierten Ablöseplan.
Fehlt ein Herstellerpatch, müssen kompensierende Kontrollen festgelegt werden. Dazu zählen stärkere Netzsegmentierung, eingeschränkte Administration, zusätzliche Überwachung, weniger exponierte Schnittstellen und ein verbindlicher Migrationsplan. Für Server ohne verfügbare Patches liefert der BSI-Rahmen die Anforderungen, nach Schweregrad und Bedrohungslage passende Massnahmen festzulegen und nachzuweisen.
Für die organisatorische Einordnung hilft ein guide to software compliance, besonders bei der Überführung technischer Nachweise in Governance-Prozesse. Die Dokumentation sollte aus Freigaben, Scans, Tickets und Prüfungen entstehen, nicht erst vor einem Audit.
Die Übersicht zur EU-NIS2-Richtlinie ordnet die europäischen Anforderungen ein. Für den deutschen Mittelstand wird Patchmanagement damit zu einem überprüfbaren Bestandteil des Risikomanagements. Hotpatching kann Ausfallzeiten reduzieren, ersetzt aber weder Inventar, Validierung noch die Entscheidung, welche Systeme ein kontrolliertes Wartungsfenster benötigen.
GSL Groß GmbH unterstützt Unternehmen beim Aufbau und Betrieb von Managed Windows Servern, einschliesslich Monitoring, Wartung, Backup und Microsoft-Server-Administration. Besprechen Sie Patchfenster, Validierungsroutinen und NIS2-Nachweise mit dem Team und besuchen Sie GSL Groß GmbH, um den nächsten Umsetzungsschritt zu planen.